같은 날 나온 두 모델, 어느 쪽을 골라야 할까요
2026년 9월 22일 하루에 두 회사의 새 모델이 함께 나왔습니다. Anthropic은 Claude Opus 5.5를 공개하면서 가격을 이전 모델보다 20% 내렸고, OpenAI는 GPT-6 Sol을 공개하면서 신규 토큰 단가를 이전 세대의 절반으로 낮췄습니다. 프로젝트에 어떤 모델을 붙일지 정해야 하는 입장에서는 발표문 두 개를 오가며 읽는 것만으로도 하루가 갑니다. 이 글에서는 두 모델의 공식 발표와 가격 문서, 독립 평가 수치에 더해, 출시 후 일주일 동안 쌓인 실사용 후기까지 모아서 어떤 프로젝트에 어느 쪽이 맞는지 정리합니다.
먼저 결론에 해당하는 사실 세 줄입니다.
- 공개된 벤치마크는 Opus 5.5 우위: 두 회사가 공통으로 발표한 유일한 벤치마크에서 40.0% 대 33.2%로 앞섰고, 독립 평가 지수에서도 앞섭니다.
- 신규 토큰 단가는 GPT-6 Sol이 절반: 입력·출력 기준 $2/$10 대 $4/$20입니다. 캐시 읽기(한 번 보낸 내용을 다음 요청에서 다시 보낼 때 그 반복된 부분에 붙는 할인 요금)는 $0.20으로 같습니다.
- 일주일치 실사용 후기도 같은 방향으로 갈립니다: 품질 체감은 Opus 쪽 호평이 많고, Sol은 비용·사용량 여유가 강점인 대신 "이전 세대보다 퇴보했다"는 보고가 반복됩니다.
라인업 안에서 두 모델의 자리가 다릅니다
Claude Opus 5.5는 Anthropic의 상용 최상위 라인인 Opus의 신형입니다. Anthropic은 발표문에서 "대부분의 작업에서 자사 최고 등급 모델인 Fable 5.1 수준의 성능을 낸다"고 썼습니다. 자기 회사의 더 비싼 모델을 겨냥한 발표인 셈입니다. 반면 GPT-6 Sol은 GPT-6 세대의 중간 모델입니다. OpenAI의 공식 설명은 "복잡한 코딩과 에이전트 워크플로를 위한 모델"이고, 위로는 최상위 모델 GPT-6 Astra가, 아래로는 경량 모델 Luna가 있습니다.
이 자리 차이가 두 발표의 성격을 갈랐습니다. 해커뉴스에서 GPT-6 Sol에 붙은 평가는 "지능은 이전 세대와 비슷하고, 실질은 50% 가격 인하"였습니다. 저희가 보기에도 Opus 5.5는 성능 카드, Sol은 가격 카드에 가깝습니다. 그래서 이 비교는 "누가 더 똑똑한가" 하나로 끝나지 않고, 가격 구조와 실사용 반응까지 같이 봐야 합니다.
Anthropic의 Claude Opus 5.5 발표 페이지로, 출시일 2026년 9월 22일이 명시돼 있습니다. (출처 : Anthropic, 2026)
Claude Opus 5.5 공식 발표 바로가기
GPT-6 Sol·Luna 공식 발표 바로가기
가격: 표면 단가와 실제 청구액은 다르게 움직입니다
공식 가격 문서 기준으로 100만 토큰당 단가는 이렇습니다.
- GPT-6 Sol: 입력 $2, 출력 $10, 캐시 읽기 $0.20 (OpenAI 공식 가격 문서)
- Claude Opus 5.5: 입력 $4, 출력 $20, 캐시 읽기 $0.20, 캐시 저장 $5 (Anthropic 공식 가격 문서)
- 컨텍스트 윈도우는 둘 다 100만 토큰급, 최대 출력도 둘 다 128K로 같습니다 (각사 공식 모델 문서)
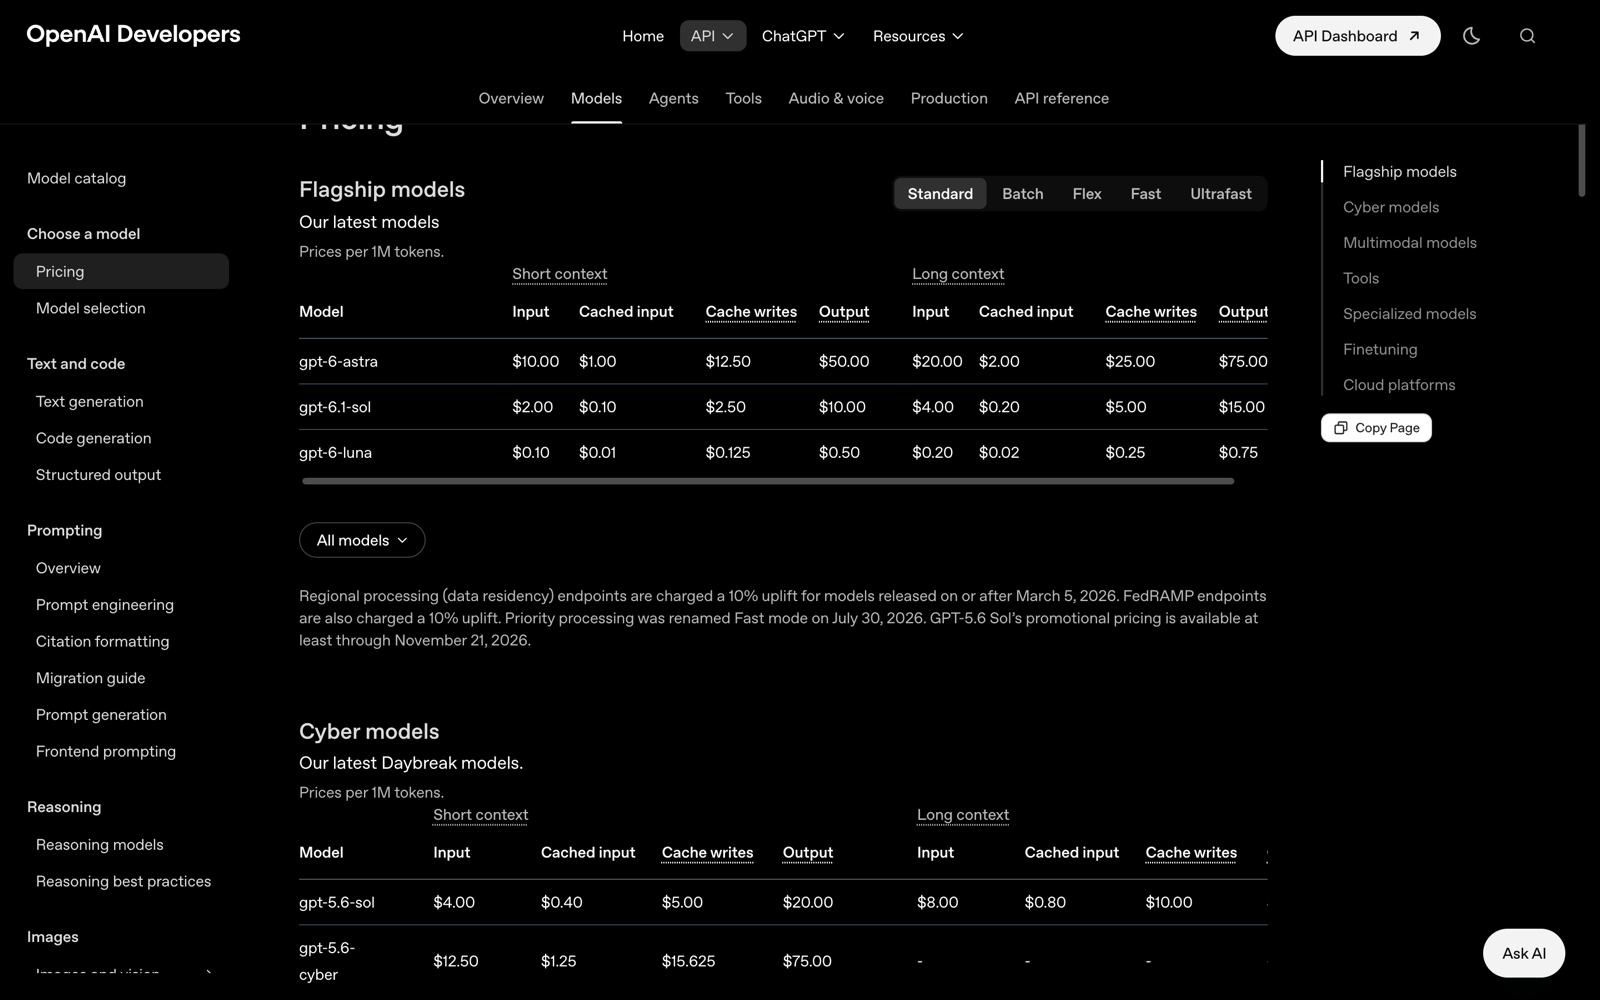
OpenAI 공식 가격 문서의 플래그십 표로, GPT-6 Sol 자리에는 이미 후속 모델 GPT-6.1 Sol이 올라와 있습니다. (출처 : developers.openai.com, 2026)
표면 단가만 보면 Sol이 정확히 절반입니다. 다만 실제 청구액은 두 가지 변수를 더 탑니다. 하나는 캐시입니다. 같은 문서를 반복해서 읽는 에이전트 작업에서는 캐시 읽기 요금이 지배적인데, 이 값은 두 모델이 $0.20으로 같습니다. 다른 하나는 작업당 토큰 사용량입니다. 독립 평가 기관 Artificial Analysis의 측정에서 Opus 5.5는 최대 추론 설정 기준 작업당 약 11만 9천 토큰을 출력해, 약 2만 7천 토큰을 쓴 GPT-6 Astra보다 네 배 이상 길게 말했습니다. Opus 5.5처럼 단가가 높은 쪽이 토큰까지 더 쓰면, 실제 격차는 단가 차이보다 커집니다. 반대로 캐시 비중이 큰 워크로드라면 체감 차이는 표면 단가 차이보다 작아집니다. 어느 쪽으로 기울지는 우리 프로젝트의 호출 패턴에 달려 있어요.
벤치마크: 두 회사가 겹치게 발표한 수치는 하나뿐입니다
모델 발표문의 벤치마크 표는 각사가 자기에게 유리한 종목을 고르기 때문에, 같은 종목이 양쪽 표에 다 있는 경우가 드뭅니다. 이번에 겹친 종목은 컴퓨터 업무 자동화 능력을 재는 AutomationBench 하나였습니다.
- AutomationBench: Opus 5.5 40.0%, GPT-6 Sol 33.2% (각사 발표 수치)
- Artificial Analysis 지능 지수: Opus 5.5 58, GPT-6 Astra 53 (기관 공식 아티클). GPT-6 Sol은 이 지수 차트에 아직 오르지 않았고, 집계 사이트 경유 수치로는 GPT-5.6 세대와 비슷한 48로 전해집니다
- 같은 기관의 코딩 에이전트 지수: Opus 5.5 66, GPT-6 Sol 57 (Sol 수치는 집계 경유)
- 측정 환경에 따라 점수가 달라집니다: 터미널 작업 벤치마크 Terminal-Bench 4.0에서 Anthropic 자체 발표는 66.4%였지만, 같은 기관의 독립 측정에서는 59.6%로 GPT-6 Astra와 동률이었습니다.
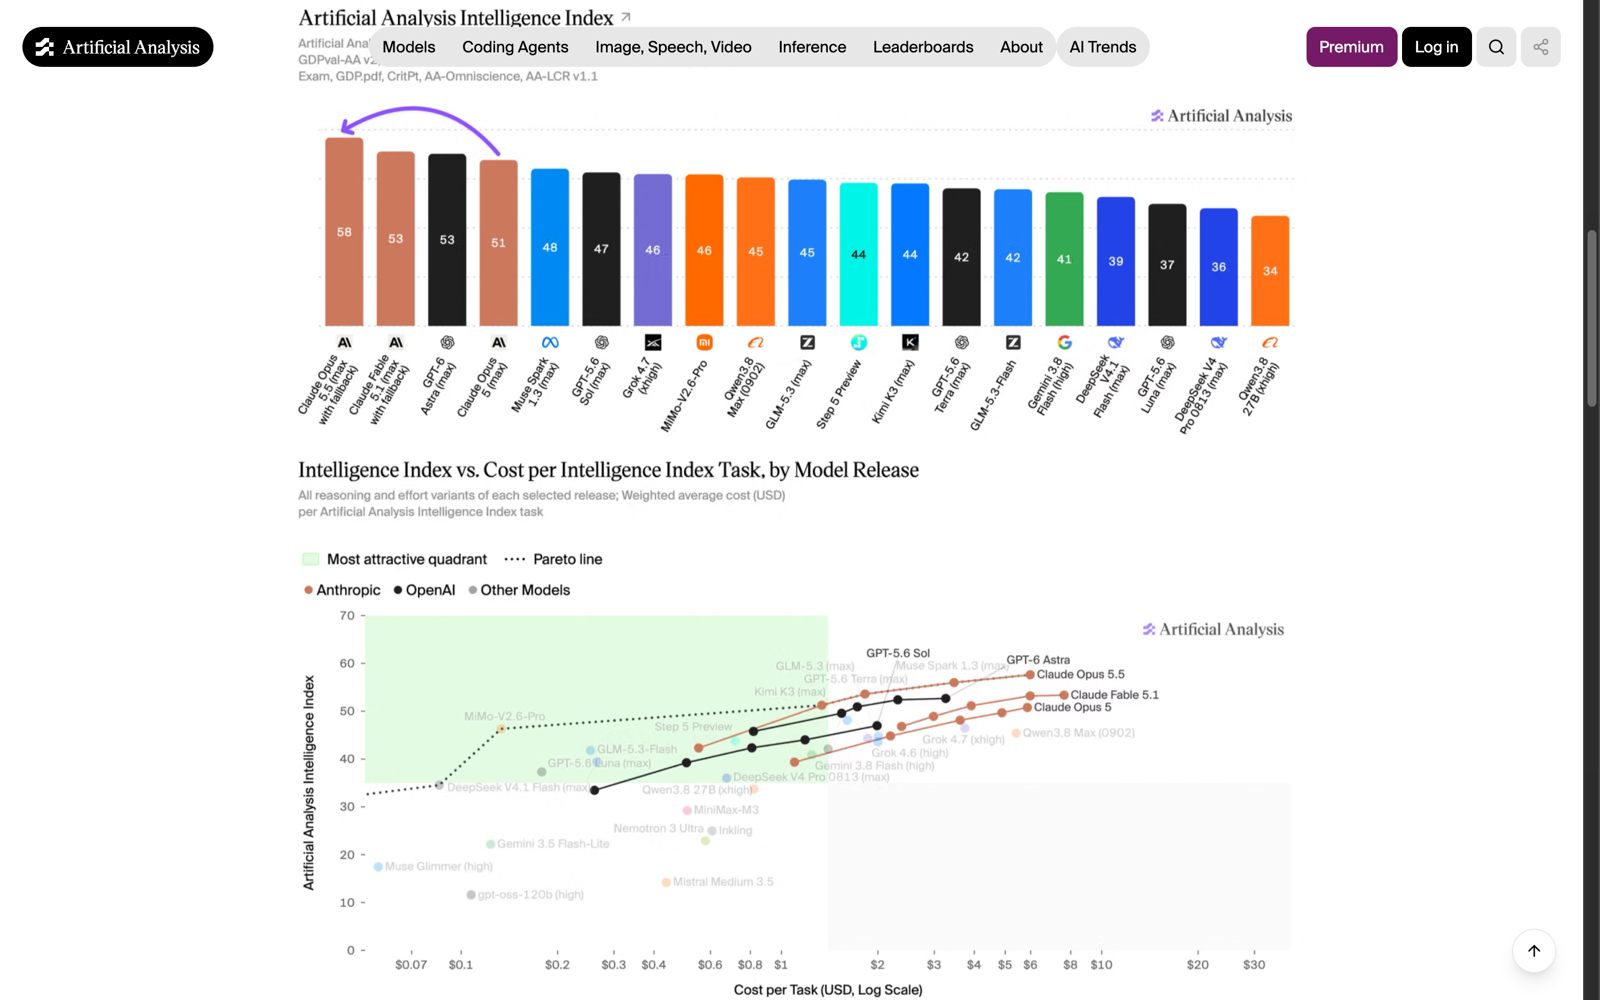
독립 평가 기관의 지능 지수 차트로, 여기서 볼 것은 맨 왼쪽 Claude Opus 5.5의 58점과 GPT-6 Astra의 53점입니다. (출처 : artificialanalysis.ai, 2026)
정리하면 공개된 수치 기준으로 코딩·에이전트 계열은 Opus 5.5가 앞서는 경향이 일관됩니다. 지능 지수 58은 이 기관이 측정한 역대 모델 가운데 가장 높은 값이기도 합니다. 다만 GPT-6 Sol 쪽 상대 수치 일부는 2차 집계를 거친 값이라, 정밀한 수치가 필요하다면 기관 원문을 직접 확인하시는 게 안전합니다. 그리고 벤치마크 표가 말해 주지 않는 것이 있습니다. 실제로 일주일 써 본 사람들의 반응입니다.
Claude Opus 5.5 실제 후기: "말이 통한다"는 체감
출시 당일 열린 해커뉴스 스레드는 1,806포인트를 모았고, 실사용 보고에서 가장 자주 반복된 단어는 성능 점수가 아니라 소통이었습니다. 사용자 thefourthchime은 "Fable 5.1보다 결과가 훨씬 좋고, 무슨 말을 하는지 이해할 수 있게 됐다"고 썼고, 레딧 r/ClaudeCode에서는 "Opus 5와 비교하면 소통 방식이 자릿수가 다르게 좋아졌다"는 글이 481표를 받았습니다. 구독 사용량이 예상보다 훨씬 덜 닳는다는 보고도 여럿입니다. 한 사용자는 서브에이전트 다섯 개로 14분을 디버깅했는데 5시간 한도의 15%도 쓰지 않았다고 적었습니다.
Opus 5.5 출시일 해커뉴스 스레드 바로가기
물론 반대쪽 보고도 있습니다. 같은 스레드에서 cruffle_duffle은 중요한 내용을 말더미에 파묻는 버릇이 여전하다고 지적했고, 평가기관 Vals는 가격이 내렸어도 코딩에서 토큰 소비량이 늘어 절감 효과가 일부 상쇄된다고 측정했습니다.
- 한 문장 요약: 출력이 읽기 쉬워지고 사용량 여유가 커졌다는 체감이 호평의 축입니다.
- 리스크: 장황함이 완전히 사라진 건 아니고, 토큰 소비 증가가 가격 인하를 일부 상쇄한다는 측정이 있습니다.
Claude Opus 5.5 실제 후기: "최대 설정보다 중간 설정"이라는 계산
개발자 Moe Lueker는 자기 블로그 리뷰에서 Claude Code의 기본 모델을 Opus 5.5로 바꾼 근거를 숫자로 공개했습니다. 코딩 벤치마크 FrontierCode 기준으로 추론 강도 중간(medium)은 54.6%를 맞히며 작업당 $0.80이 들었는데, 최대(max)는 54.4%에 $6.19가 들었습니다. 최대 설정은 중간 설정과 같은 성능에 값만 7.7배였다는 계산입니다. 중간 설정이 Fable 5.1의 최대 설정(50.3%, 작업당 $12.83)보다도 높았다는 결과도 함께 적었습니다.
Moe Lueker의 Opus 5.5 리뷰 바로가기
최대 설정에 대한 경고는 다른 곳에서도 나왔습니다. 개발자 도구 블로거 Simon Willison은 출시일 리뷰에서 max 모드가 간단한 SVG 그림 하나에 128K 출력 한도를 다 써 버릴 만큼 과하게 생각한다며, 그 모드는 신뢰하기 어렵다고 썼습니다. 그러면서도 명확한 소통과 토큰 효율을 이유로 자기 도구의 기본 모델로는 채택했습니다. 코드 품질 쪽에서는 Roos 뉴스레터의 Ved Vyas가 Java 벤치마크에서 출력 토큰이 40% 줄어든 대신 코드 라인당 버그 밀도가 12% 늘었고 특히 동시성 버그가 44% 늘었다고 측정했습니다.
- 한 문장 요약: 여러 실측이 "중간 설정이 실속"이라는 같은 결론에 도달했습니다.
- 리스크: 최대 설정의 과잉 사고, 그리고 줄어든 출력 안에 버그가 더 촘촘해졌다는 측정은 검수 없이 믿고 쓰면 안 된다는 뜻입니다.
GPT-6 Sol 실제 후기: 반값과 여유는 진짜, 품질은 논쟁 중
Sol의 강점 보고는 일관되게 비용과 사용량입니다. 해커뉴스에서 redox99는 $100 구독에서 Sol은 거의 무제한처럼 느껴진다고 썼고(Astra는 하루면 소진), 40분 작업에 사용량 1%가 닳는다는 실측도 올라왔습니다. 방향이 반대인 실측도 있습니다. 브라우저 에이전트 개발사 Browser Use 팀의 자체 벤치마크에서는 Sol이 66.9점으로 Opus 5.5의 59.4점을 앞섰고 비용은 약 3분의 1이었습니다. 코드 리뷰에서 근거 없는 지적을 잘 걸러낸다는 평가도 있습니다.
문제는 품질 쪽에서 "이전 세대보다 퇴보했다"는 보고가 이어진다는 점입니다. 해커뉴스에서 반년 넘게 Codex를 주력으로 쓰던 the_duke는 "Sol 6가 너무 나빠서 Opus 5.5로 완전히 갈아탔다, 5.6 Sol 대비 큰 퇴보"라고 썼고, 답글에서 여러 사용자가 동조하거나 이전 버전으로 되돌렸다고 밝혔습니다. r/codex에서도 비슷한 보고가 다수라는 지적이 나왔습니다. 운영 관점에서는 질문 거부율이 1%에서 17%로 급증해 무인 자동화 파이프라인이 중간에 멈춘다는 분석도 있었습니다 (환각률을 92%에서 60%로 낮추는 과정의 대가로 해석됩니다).
GPT-6 Sol 출시일 해커뉴스 스레드 바로가기
- 한 문장 요약: 사용량 여유와 특정 작업(브라우저 에이전트, 코드 리뷰)의 강세는 실측으로 확인되지만, "5.6보다 퇴보"라는 실사용 보고가 반복해서 나옵니다.
- 리스크: 거부율 급증은 사람 없이 돌아가는 자동화에서 치명적일 수 있습니다.
둘 다 번갈아 써 본 사람들의 판정
한쪽 모델만 쓴 후기는 아무래도 자기 진영의 이야기가 됩니다. 그래서 저희는 두 모델을 같은 작업에 나란히 돌린 기록만 따로 추렸는데, 공개된 글 가운데 이 조건을 제대로 갖춘 비교는 생각보다 적었습니다. 그중 가장 공을 들인 기록은 자동화 유튜버 Nate Herk의 실무 태스크 10개 비교였습니다. 그는 Opus 5.5는 전작보다 눈에 띄게 나아졌는데 GPT-6 Sol은 전작과 차이를 못 느끼겠다는 의심에서 출발해, 웹 디자인부터 영상 편집, 브라우저 작업까지 열 개를 두 모델에 똑같이 맡겼습니다. 채점이 가능했던 여덟 개 가운데 일곱 개를 Opus가 가져갔고, Sol이 이긴 건 테스트 30개를 전부 통과해야 하는 코드 수리 하나였습니다.
그런데 청구서는 반대 방향이었습니다. Opus는 8시간 40분을 돌며 $213을 썼고, Sol은 5시간 51분에 $74로 끝냈습니다. 그래서 그의 결론도 승자 선언이 아니라 역할 분담이었습니다. 전체를 지휘하는 자리에는 Opus를 두고, 명세가 확실한 작업은 Sol에게 넘기는 방식입니다.
범위를 과제 하나로 좁히면 판정이 뒤집히기도 합니다. DataCamp의 Tom Farnschläder가 같은 도구, 같은 설정으로 중력 반전 테트리스를 만들게 했더니 종합 점수 5.0 대 4.3으로 Sol이 이겼고, 비용도 $0.26 대 $0.87로 Sol이 쌌습니다. 본인 말대로 한 번의 실행이라는 한계는 있지만, 요구사항이 또렷한 단일 과제에서는 Sol이 더 싸고 더 매끈할 수 있다는 걸 보여 주는 장면입니다. 모델명을 가린 채 여러 작업을 채점한 Lenny's Newsletter의 Claire Vo도 비슷한 자리에서 갈라졌습니다. 오래 걸리는 에이전트 작업과 B2B 화면은 Opus, 글의 명료함과 가성비는 Sol이었습니다.
결이 다른 세 기록이 같은 자리에 선을 긋고 있습니다. 넓게 맡기면 Opus가, 좁고 명확하게 맡기면 Sol이 실속입니다.
일주일 만에 변수가 생겼습니다: GPT-6.1 Sol
이 비교에는 유효기간 문제가 하나 있습니다. 9월 29일 OpenAI가 개발자 행사 DevDay에서 GPT-6 Sol의 개선판인 GPT-6.1 Sol을 발표했습니다. 가격은 같은 $2/$10인데 캐시 읽기 요금이 $0.10으로 다시 절반이 됐고, OpenAI는 "Astra급 지능을 5분의 1 가격에" 제공한다고 설명했습니다. 함께 준비되던 GPT-6.1 Astra는 내부 안전 테스트 문제로 출시가 취소됐다는 보도가 있습니다 (월스트리트저널 보도 기반, OpenAI 공식 확인은 없음).
발표 당일 해커뉴스의 첫 반응은 "Opus 5.5의 반값"이라는 가격 얘기가 중심이었고, 캐시 읽기 요금 $0.10이 진짜 헤드라인이라는 지적과 함께, GPT-6 Sol에 실망한 사용자들의 "6.1이라고 다르겠나"라는 회의도 공존했습니다. 출시 하루 만에 판단하기는 이르다는 자성도 있었어요. 지금 시점에 GPT 쪽을 검토한다면 실질 비교 대상은 GPT-6 Sol보다 GPT-6.1 Sol이고, 실사용 후기는 이제 쌓이기 시작한 단계입니다.
GPT-6.1 Sol 공식 발표 바로가기
벤치마크 순위와 실무 판정이 뒤집힌 적이 있습니다
숫자와 후기를 이렇게 모아 놓고도 저희가 순위를 단정하지 않는 이유가 있습니다. 직전 세대에서 저희는 GPT-5.6 Sol 기반 Codex와 Claude Opus 5에 실제 외주 프로젝트를 통째로 맡겨 봤습니다. 저희 실험에서 화면을 가장 보기 좋게 만든 쪽은 GPT-5.6 Sol이었지만, 실무 시나리오 10개 검수에서 통과는 0개였고 Opus 5는 9개였습니다. 그 기록은 GPT-5.6 Codex vs Claude Opus 5 실사용 비교에 정리해 두었습니다. 벤치마크 표에서 몇 점 차이 나는 두 모델이 실제 프로젝트에서는 이만큼 다르게 일할 수 있다는 뜻입니다.
어떤 프로젝트에 어느 쪽일까요
지금까지의 수치와 후기를 발주·도입 판단 기준으로 바꾸면 세 가지입니다.
반복 호출이 많고 비용 상한이 뚜렷한 자동화라면 GPT-6.1 Sol부터 검토할 만합니다. 캐시 설계를 전제로 하면 신규 토큰 절반 단가와 캐시 읽기 요금 $0.10이 대량 호출에서 그대로 비용 차이가 됩니다. 단, 거부율 급증 같은 운영 변수는 무인 파이프라인에서 먼저 확인해야 합니다.
취소·정정·권한처럼 막고 되돌리는 흐름까지 확인해야 하는 출시용 개발이라면 Opus 5.5를 먼저 검토할 만합니다. 공개 수치와 일주일치 후기가 모두 이쪽을 가리킵니다. 이때도 후기들이 가리키는 대로 추론 강도는 최대가 아니라 중간부터 시작하는 게 실속입니다.
두 모델을 단계별로 섞어 쓰는 방법도 있습니다. 두 모델을 다 써 본 사람들의 공통 결론은 혼용이었습니다. 저희도 같은 방식으로 일합니다. 기획·구현·검수 단계마다 다른 모델을 배치하고, 어느 모델이든 마지막 판정은 현장 시나리오 검수로 합니다.
결론: 수치와 후기는 Opus, 단가는 Sol, 결정은 워크로드
공개된 성능 수치와 일주일치 실사용 후기는 Claude Opus 5.5 쪽으로 기울고, 신규 토큰 단가와 사용량 여유는 GPT-6 Sol 계열이 앞섭니다. 두 모델 사이에서 답을 정하는 건 벤치마크가 아니라 우리 프로젝트의 호출 패턴과 검수 기준입니다. 리트머스는 새 모델이 나올 때마다 실제 프로젝트 자료로 검증한 뒤 기획, 구현, 검수 단계마다 다른 모델을 배치하고, 마지막 판정은 사람이 현장 시나리오로 합니다. 우리 프로젝트가 바이브코딩 외주에 적합한지부터 무료로 검토해드립니다.
발표 수치와 남의 후기까지 봤다면, 다음으로 궁금한 건 같은 프로젝트를 통째로 맡겼을 때 두 회사 모델이 실제로 어떻게 다르게 일하느냐일 겁니다. 직전 세대로 그 실험을 한 기록을 아래 글에 정리해 두었습니다.