가장 예쁜 화면을 만든 AI가 검수에서 하나도 통과하지 못했습니다
주소창에 접속하자 로그인 화면 없이 대시보드가 바로 열렸습니다. 레이아웃도, 글자 위계도, 탭을 넘길 때의 전환 애니메이션도 이번 실험 결과물 네 개 중 가장 좋았습니다. GPT-5.6 Sol이 Codex에서 1시간 18분 동안 만든 농산물 거래 관리 시스템이었어요. 그런데 이 결과물은 실무 시나리오 10개를 끝까지 눌러 보는 검수에서 하나도 통과하지 못했습니다. 같은 자료와 같은 프롬프트를 받은 Claude Opus 5는 9개를 통과했습니다.
"코덱스와 오푸스 중 뭘 쓸까"는 요즘 AI 코딩 도구를 고르는 팀이 가장 많이 하는 질문입니다. 지난 2월 Claude Opus 4.6과 GPT-5.3 Codex를 비교할 때는 벤치마크와 가격표로 충분했지만, 외주개발사인 저희가 정말 알고 싶은 건 따로 있었습니다. 실제 프로젝트를 통째로 맡기면 어디까지 해내고 어디서 멈추느냐입니다. 이 글에서는 두 제품이 같은 일을 어떻게 다르게 했는지 세션 기록과 검수 화면으로 따라갑니다.
같은 실험에 참여한 Fable 5와 Kimi K3까지 넣은 전체 비교는 영상에, 클로드 모델끼리의 비교는 Fable 5 vs Opus 5 실측 글에 따로 정리했습니다.
같은 문서, 같은 프롬프트, 다른 도구
실험 대상은 농산물 수거센터의 거래 관리 시스템입니다. 센터, 본사, 공공기관, 공급자, 바이어 다섯 주체가 얽힌 실제 고객 프로젝트를 익명화했고, 입력 자료 6종과 프롬프트, 시작 시각, 권한을 모두 같게 맞췄습니다. 다른 건 하네스 하나였습니다. 하네스(harness)는 모델에 파일 읽기나 명령 실행 같은 손발을 붙여 주는 작업 환경인데, GPT-5.6 Sol Max는 OpenAI의 Codex에서, Claude Opus 5는 Anthropic의 Claude Code에서 각자 기본 설정 그대로 돌렸습니다.
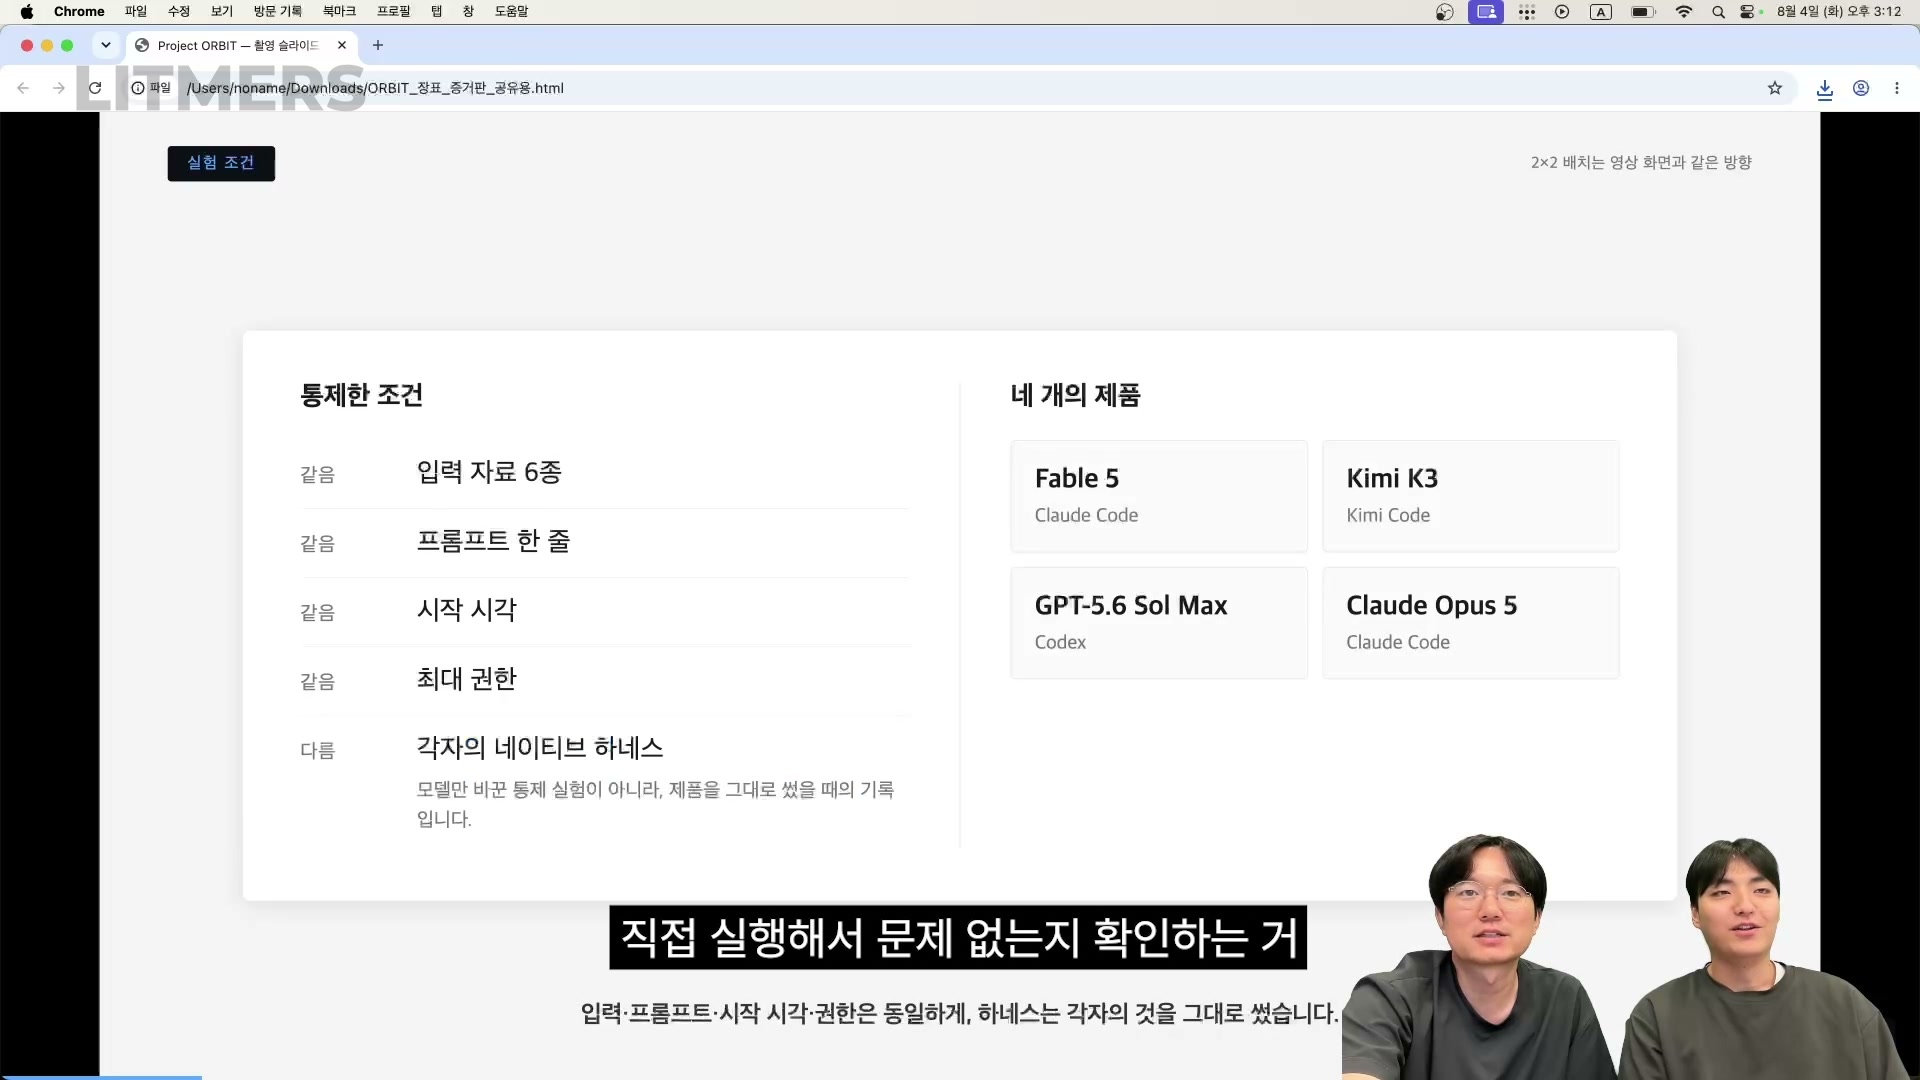
입력 자료, 프롬프트, 시작 시각, 권한은 같게 맞추고 하네스는 각자의 것을 그대로 썼습니다.
그래서 이 결과는 모델 자체의 차이라기보다, 모델과 작업 환경을 합친 제품 전체의 차이로 봐야 합니다. 변수를 하나만 바꾸는 엄밀한 실험으로 보면 약점이지만, 실제로 팀들은 GPT를 Codex에서, Claude를 Claude Code에서 쓰기 때문에 현실에는 더 가깝다고 판단했습니다. 프롬프트는 이 한 줄이었습니다.
프로젝트 자료 보고 실제 개발 좀 끝까지 해줘. 지금 있는 기본 환경에서 1차 출시본으로 최대한 완성하고, 네가 직접 실행해서 문제 없는지도 확인해줘.
실험은 2026년 7월 27일에 진행했고, 두 제품 모두 당시 버전을 추론 강도 최대로 썼습니다. 평가표도, 구현 순서도, 기술 스택도 정해 주지 않았습니다. 실제 발주도 대개 이렇게 들어오니까요. 글에 나오는 이름과 연락처는 모두 익명화한 가상 데이터입니다.
두 제품은 일하는 방식부터 달랐습니다
Codex: 혼자, 길게, 확인은 적게
세션 기록을 열어 보니 Codex는 처음부터 끝까지 혼자 일했습니다. 기록 안에 보조 에이전트를 띄우지 말라는 지시문이 들어 있었고, 작업이 길어지자 앞선 대화를 요약해 기억 공간을 비우는 컴팩션이 한 번 일어났습니다. 컴팩션 뒤에는 계획을 다시 세워 작업을 이어 갔습니다.
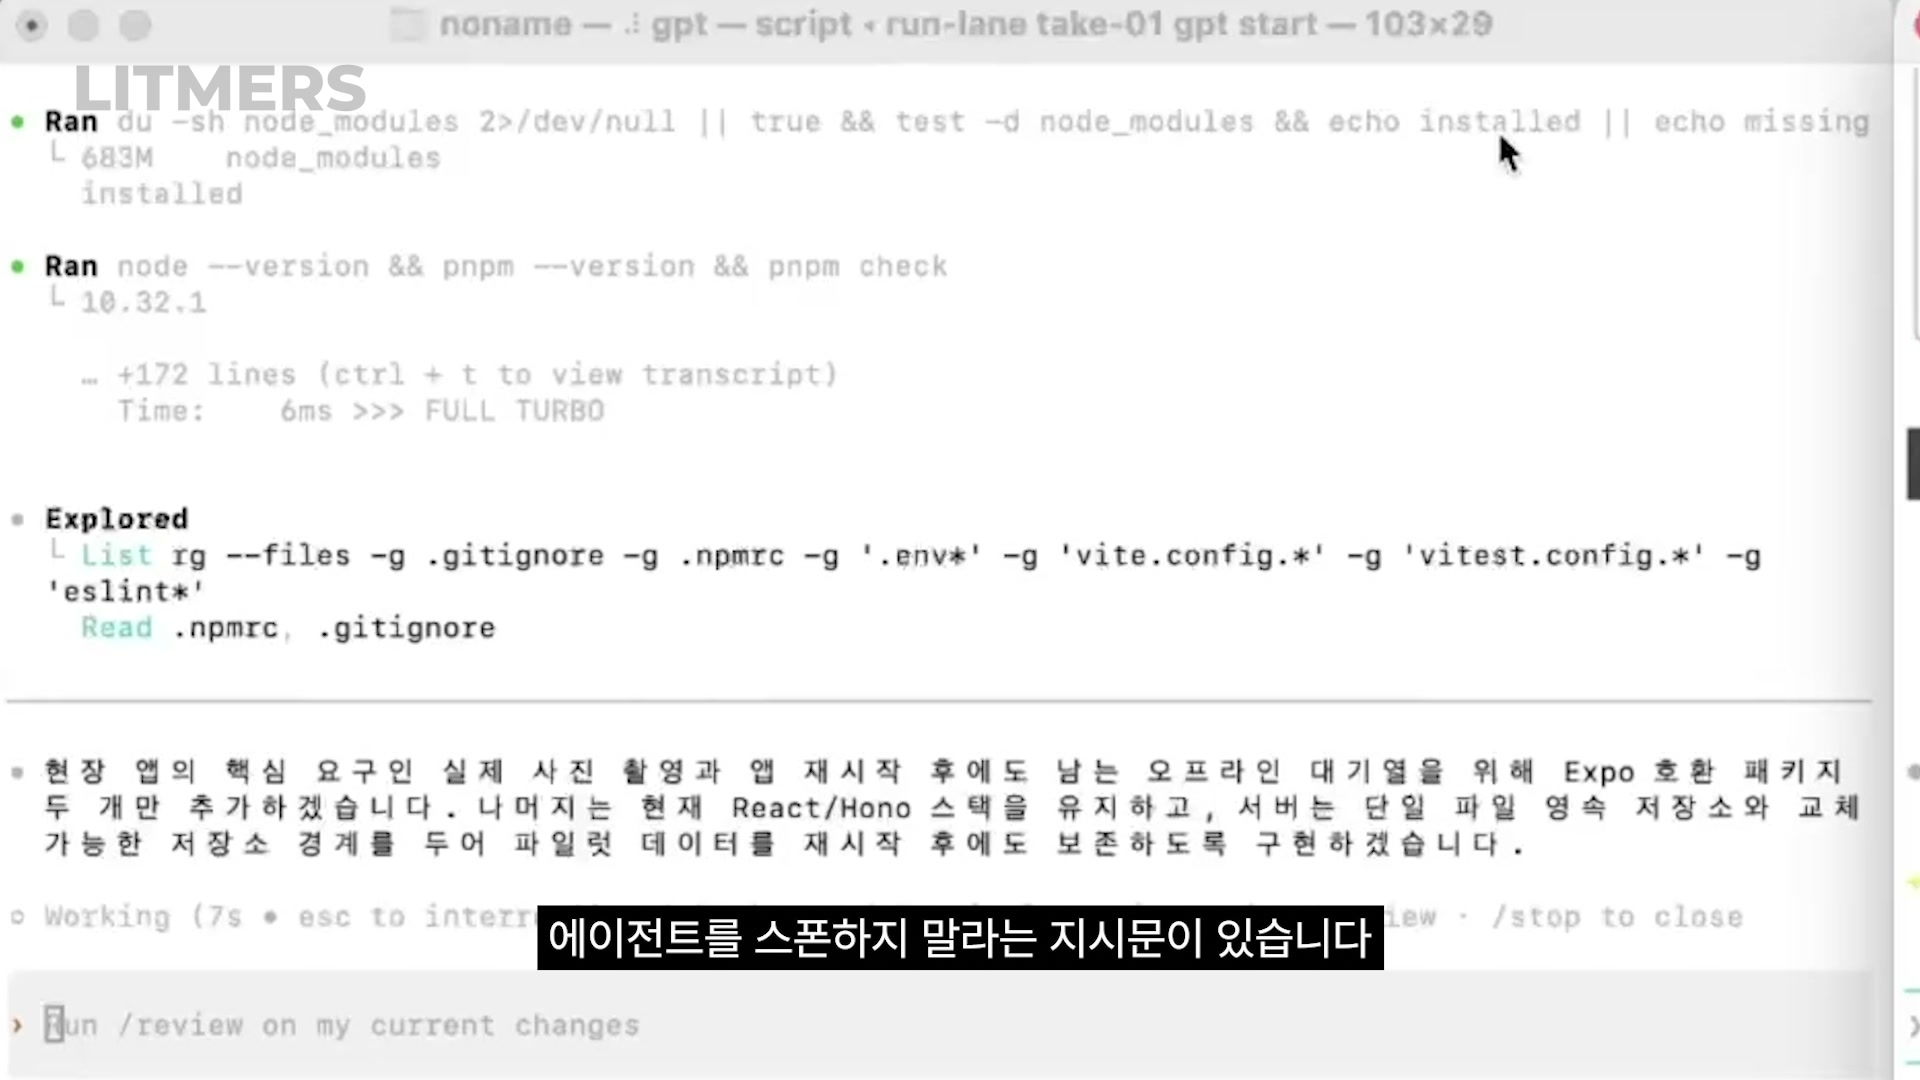
Codex 세션 기록. 보조 에이전트를 띄우지 말라는 지시가 있었고, 처음부터 끝까지 단독으로 진행했습니다.
작업 시간은 1시간 18분 28초로 네 제품 중 가장 길었고, 코드는 약 1만 3천 줄이 늘었습니다. 반면 스스로 만든 테스트는 12개로 가장 적었습니다. 작업 시간도 코드량도 많았지만, 만든 것을 다시 확인하는 데는 가장 적게 공을 들인 셈입니다.
Opus: 테스트를 다 통과시키고도 브라우저를 다시 열었습니다
Claude Opus 5도 보조 에이전트 없이 혼자 일했습니다. 작업 여덟 개를 순서대로 처리하면서 테스트 53개를 만들었고, 코드는 약 1만 6천 줄로 가장 많았습니다. 두 제품의 차이는 테스트가 전부 통과한 다음에 나왔습니다. Opus는 거기서 완료를 보고하지 않고 실제 브라우저를 띄워 결과물을 다시 눌러 봤고, 그 과정에서 로그인, 권한별 화면 접근 제한, 모바일 앱 설정값 버그 세 개를 스스로 찾아 고쳤습니다.
작업 시간은 1시간 15분 24초로 Codex와 3분 차이였어요. 두 세션을 나란히 놓으면 이렇습니다.
- GPT-5.6 Sol Max (Codex): 단독 진행, 컴팩션 1회, 테스트 12개, 코드 약 1만 3천 줄, 1시간 18분
- Claude Opus 5 (Claude Code): 단독 진행, 테스트 53개, 코드 약 1만 6천 줄, 1시간 15분, 완료 전 브라우저 재확인
- 공통 조건: 같은 문서 6종, 같은 프롬프트 한 줄, 보조 에이전트 없음
세션 비용은 Codex가 약 $22.16, Opus가 약 $71.35로 추정됩니다. 공개 단가로 계산한 값이고 제품마다 캐시와 토큰을 세는 방식이 달라서, 가격 비교에 그대로 쓰기는 어려워요.
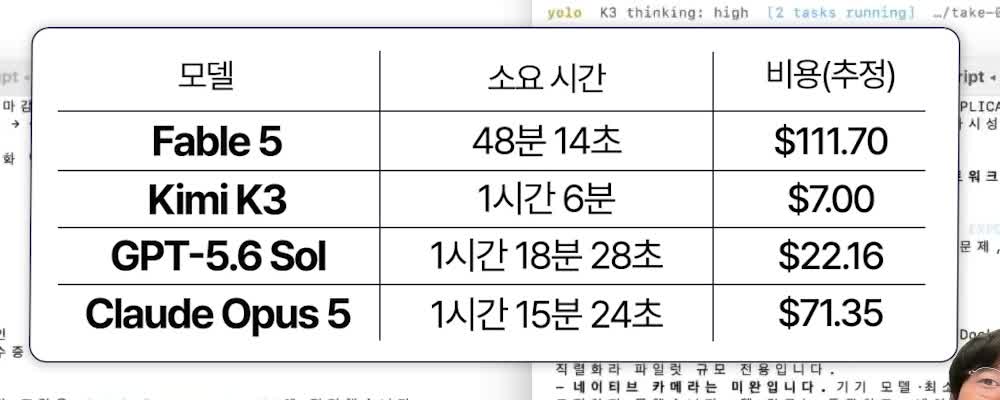
네 제품의 소요 시간과 세션 비용 · 2026년 7월 27일 측정. 비용은 공개 단가 기준 추정치입니다.
첫 화면은 GPT가 확실히 앞섰습니다
결과물을 브라우저에서 처음 열었을 때 반응은 한쪽으로 쏠렸습니다. 대시보드 레이아웃과 글자 위계, 탭 전환 애니메이션까지 GPT 쪽이 한눈에 좋았습니다. 저희도 촬영하면서 "이건 GPT-5.6이 넘사 아닌가" 하고 감탄했을 정도입니다. 저희가 새 모델마다 돌리는 테스트, 곧 수상작 웹사이트를 에셋까지 그대로 따라 만들게 하는 과제를 통과한 것도 GPT-5.6 계열뿐이었습니다.
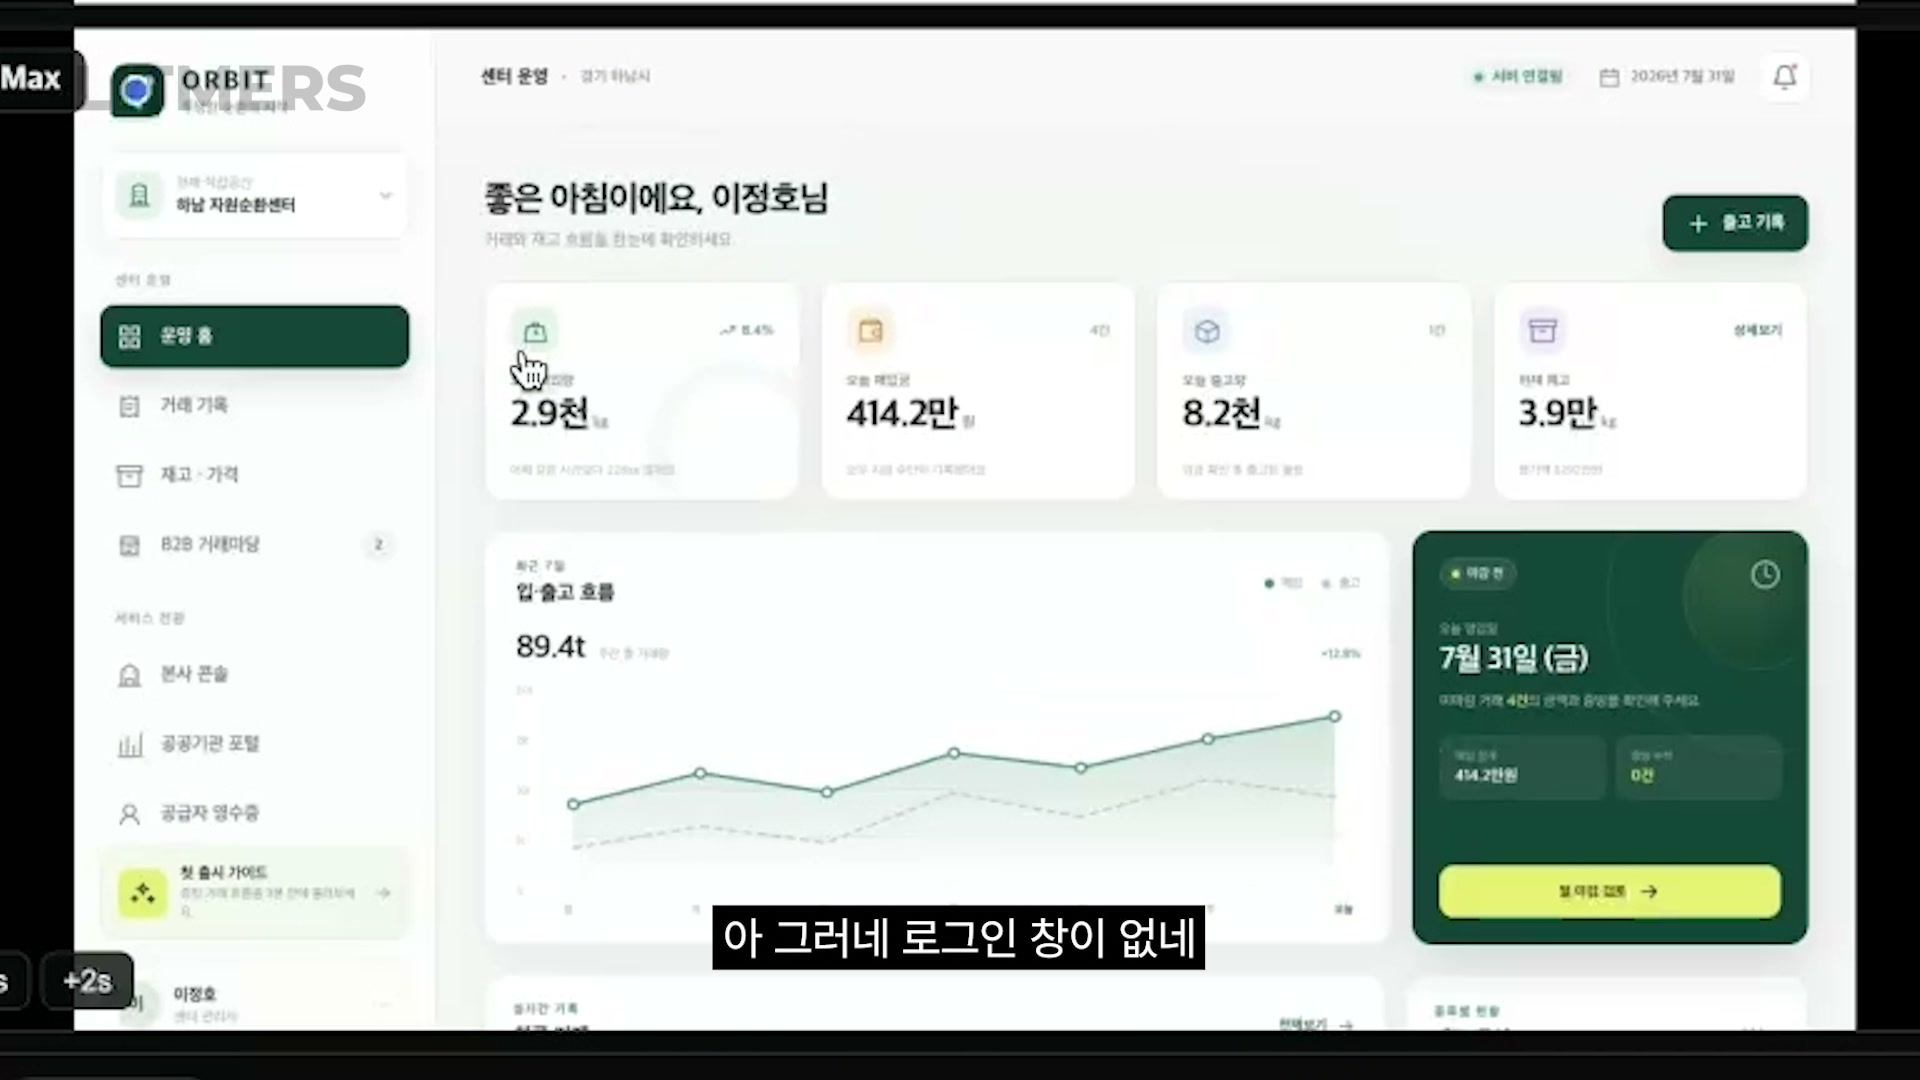
GPT-5.6 Sol의 센터 운영 대시보드. 화면 완성도는 가장 높았지만 로그인 없이 바로 열렸습니다.
다만 로그인 없이 열린다는 점이 뒤에서 드러날 문제들의 첫 번째 단서였습니다. 저희는 이 장면을 보고 GPT가 출시본이 아니라 프로토타입을 만들려 한다고 판단했습니다. 프롬프트가 요구한 건 1차 출시본이었지만, 결과물은 보여 주기용 시안에 가까웠습니다.
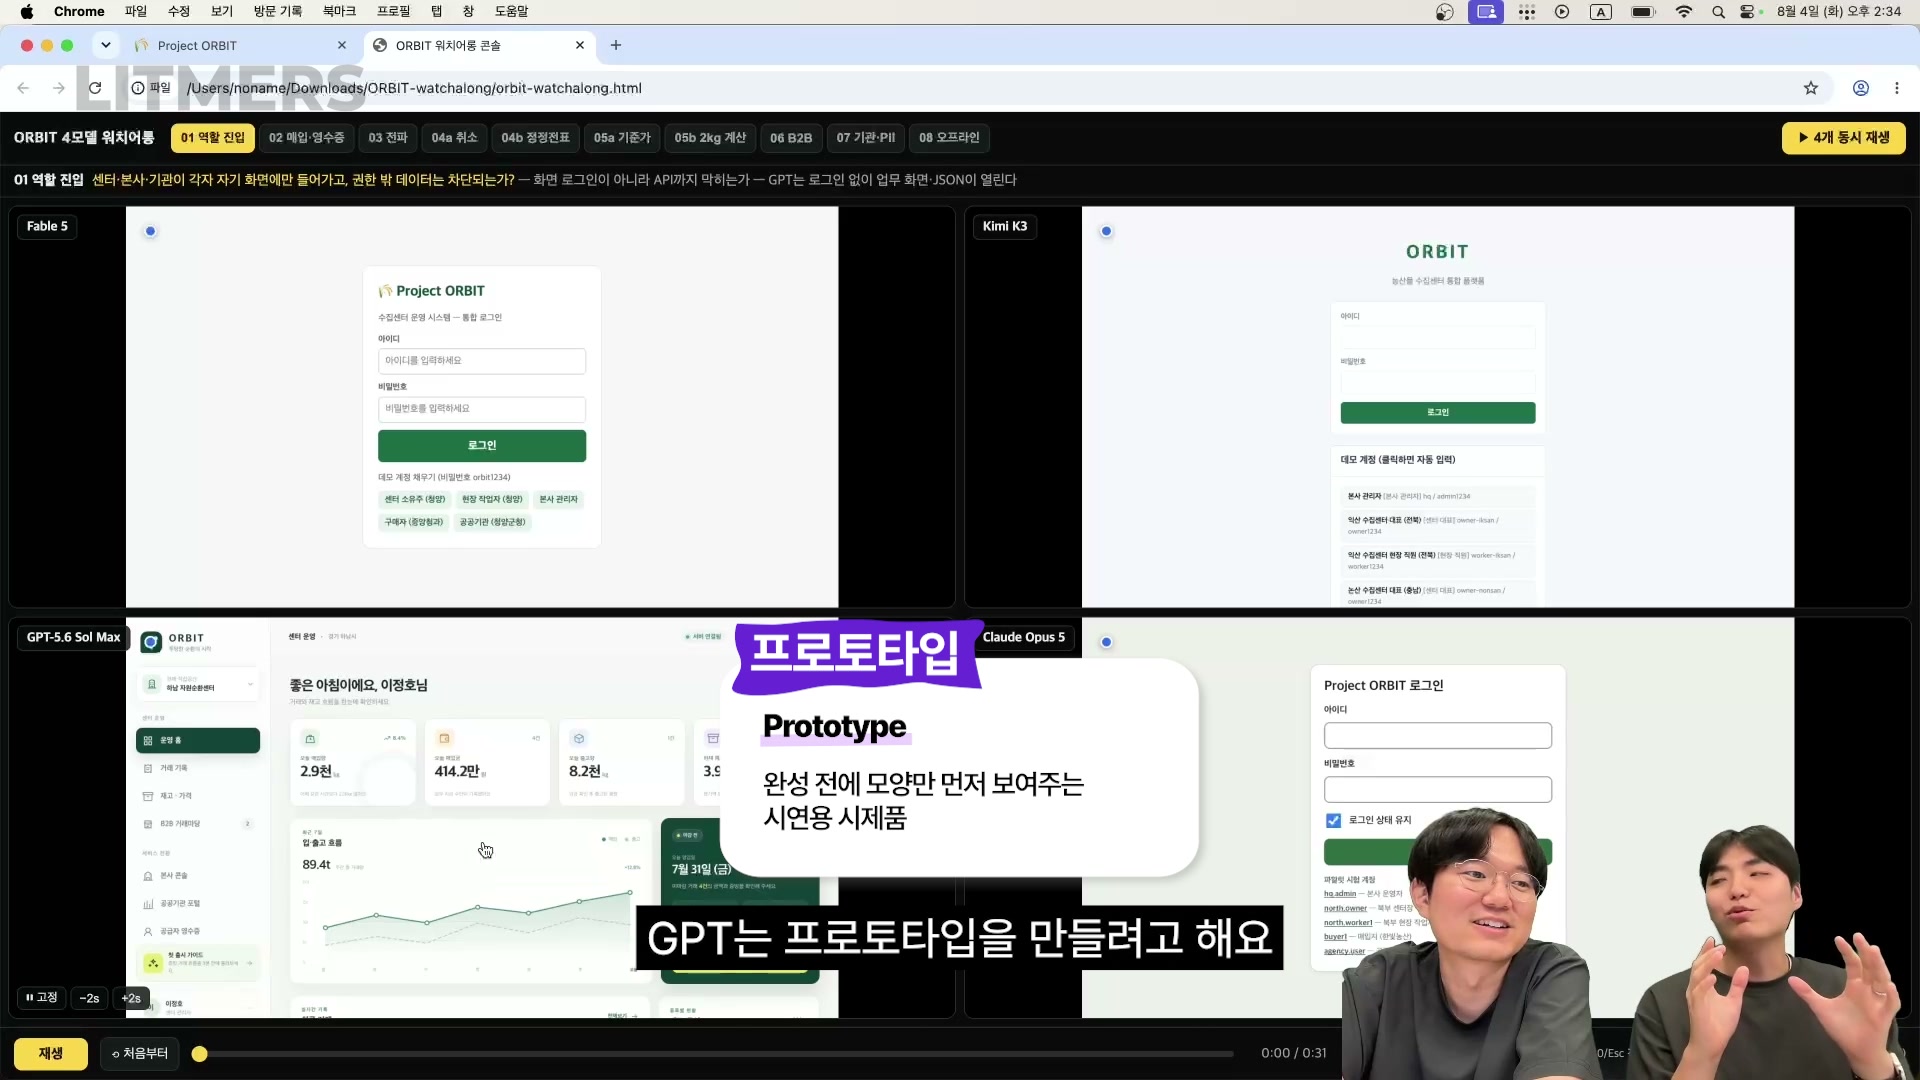
네 제품의 첫 화면. 세 제품은 로그인 화면에서 시작했고, GPT만 대시보드에서 시작했습니다.
GPT 결과물에서 막힌 세 장면
로그인 화면만 없는 게 아니었습니다
공급자 목록을 내려 주는 API 주소를 직접 열어 보니, 이름과 연락처가 인증 없이 그대로 내려왔습니다. 화면에서 메뉴를 숨기는 것과 서버에서 데이터를 막는 것은 별개인데, 이 결과물은 둘 다 하지 않았습니다. 주소만 알면 누구나 공급자의 이름과 연락처를 가져갈 수 있다는 뜻입니다. 실제 서비스였다면 이 문제 하나 때문에 출시를 멈춰야 했을 겁니다.
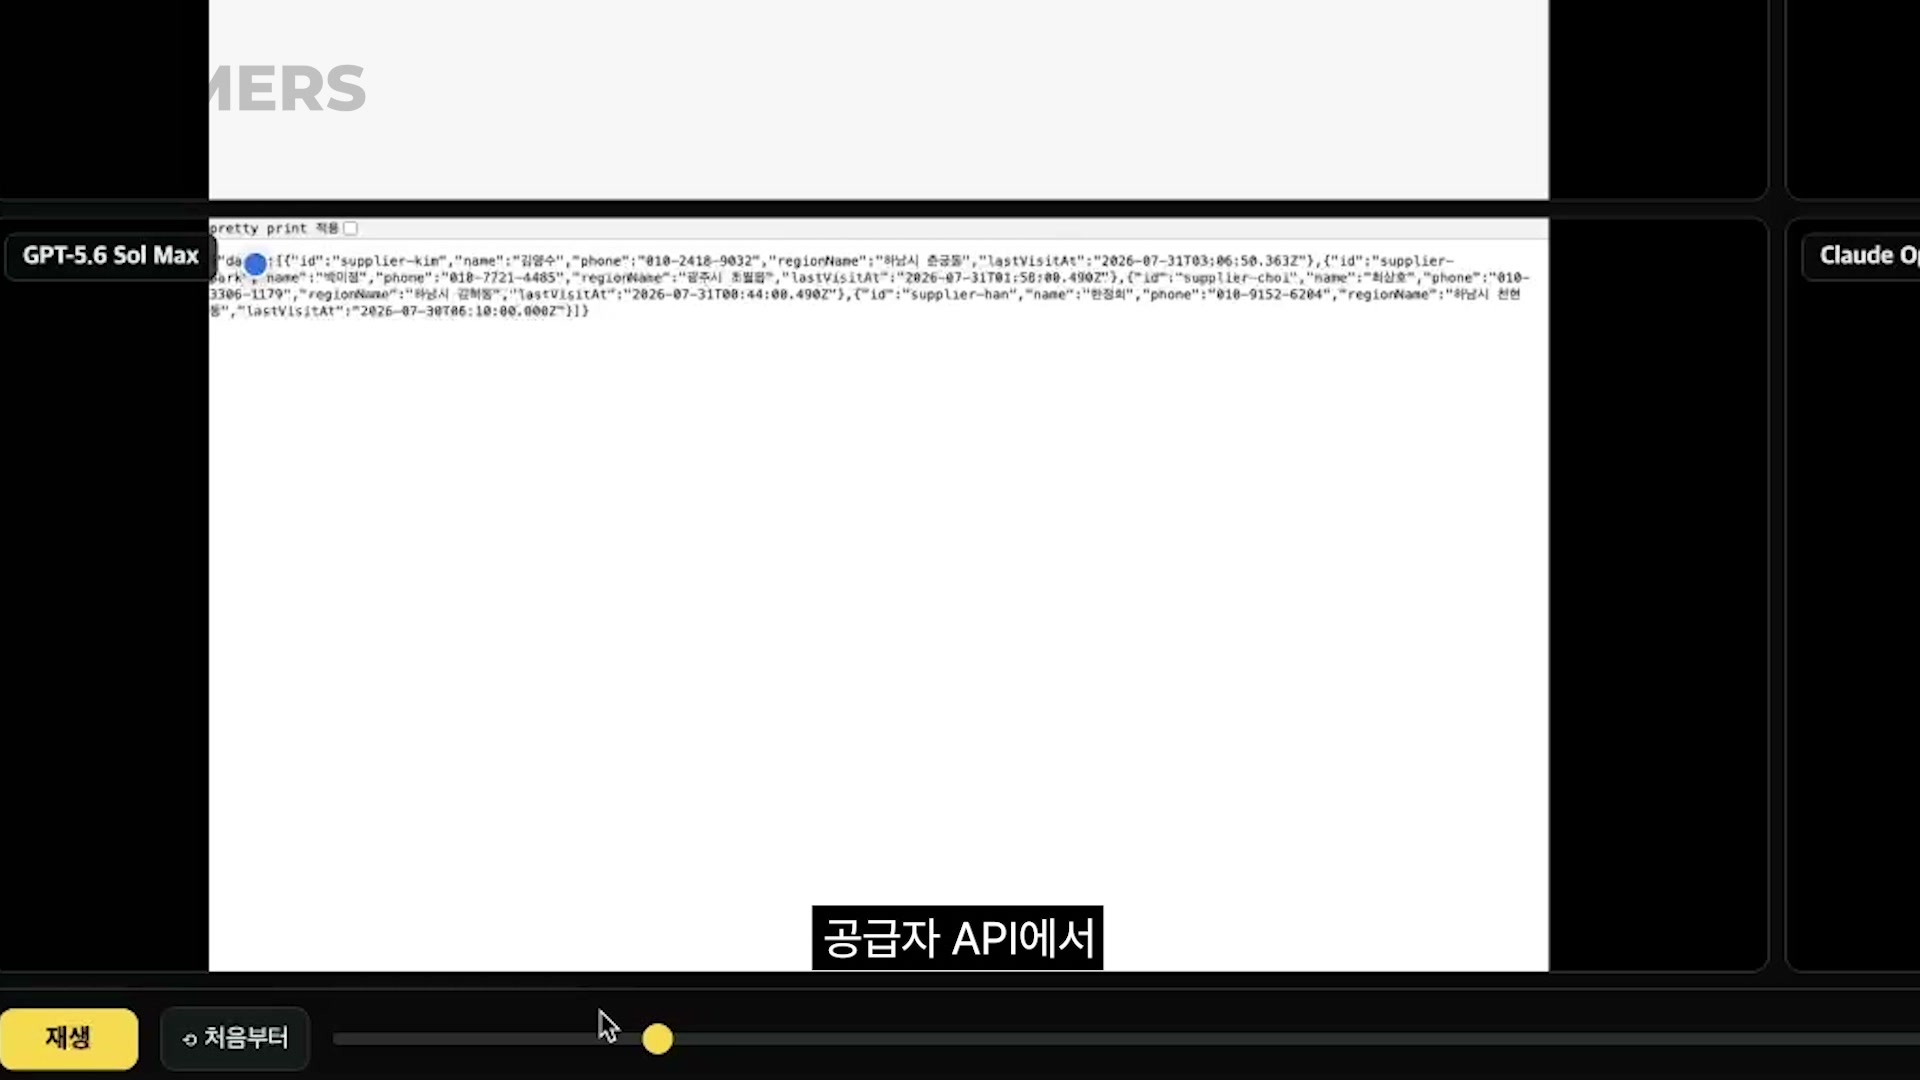
인증 없이 열린 공급자 API 응답. 이름과 연락처는 익명화한 가상 정보입니다.
45분 안에 취소하는 버튼이 없었습니다
요구사항 문서에는 현장 작업자가 거래 후 45분 안에 사유를 적고 취소할 수 있어야 한다는 규칙이 있었습니다. 누가 언제까지 취소할 수 있는지를 정하는 권한 규칙입니다. GPT 모바일 앱의 기록 화면과 보관함을 모두 열어 봤지만, 취소로 들어가는 버튼 자체가 없었습니다. 다른 세 제품은 방식은 달라도 모두 이 기능을 만들었어요.
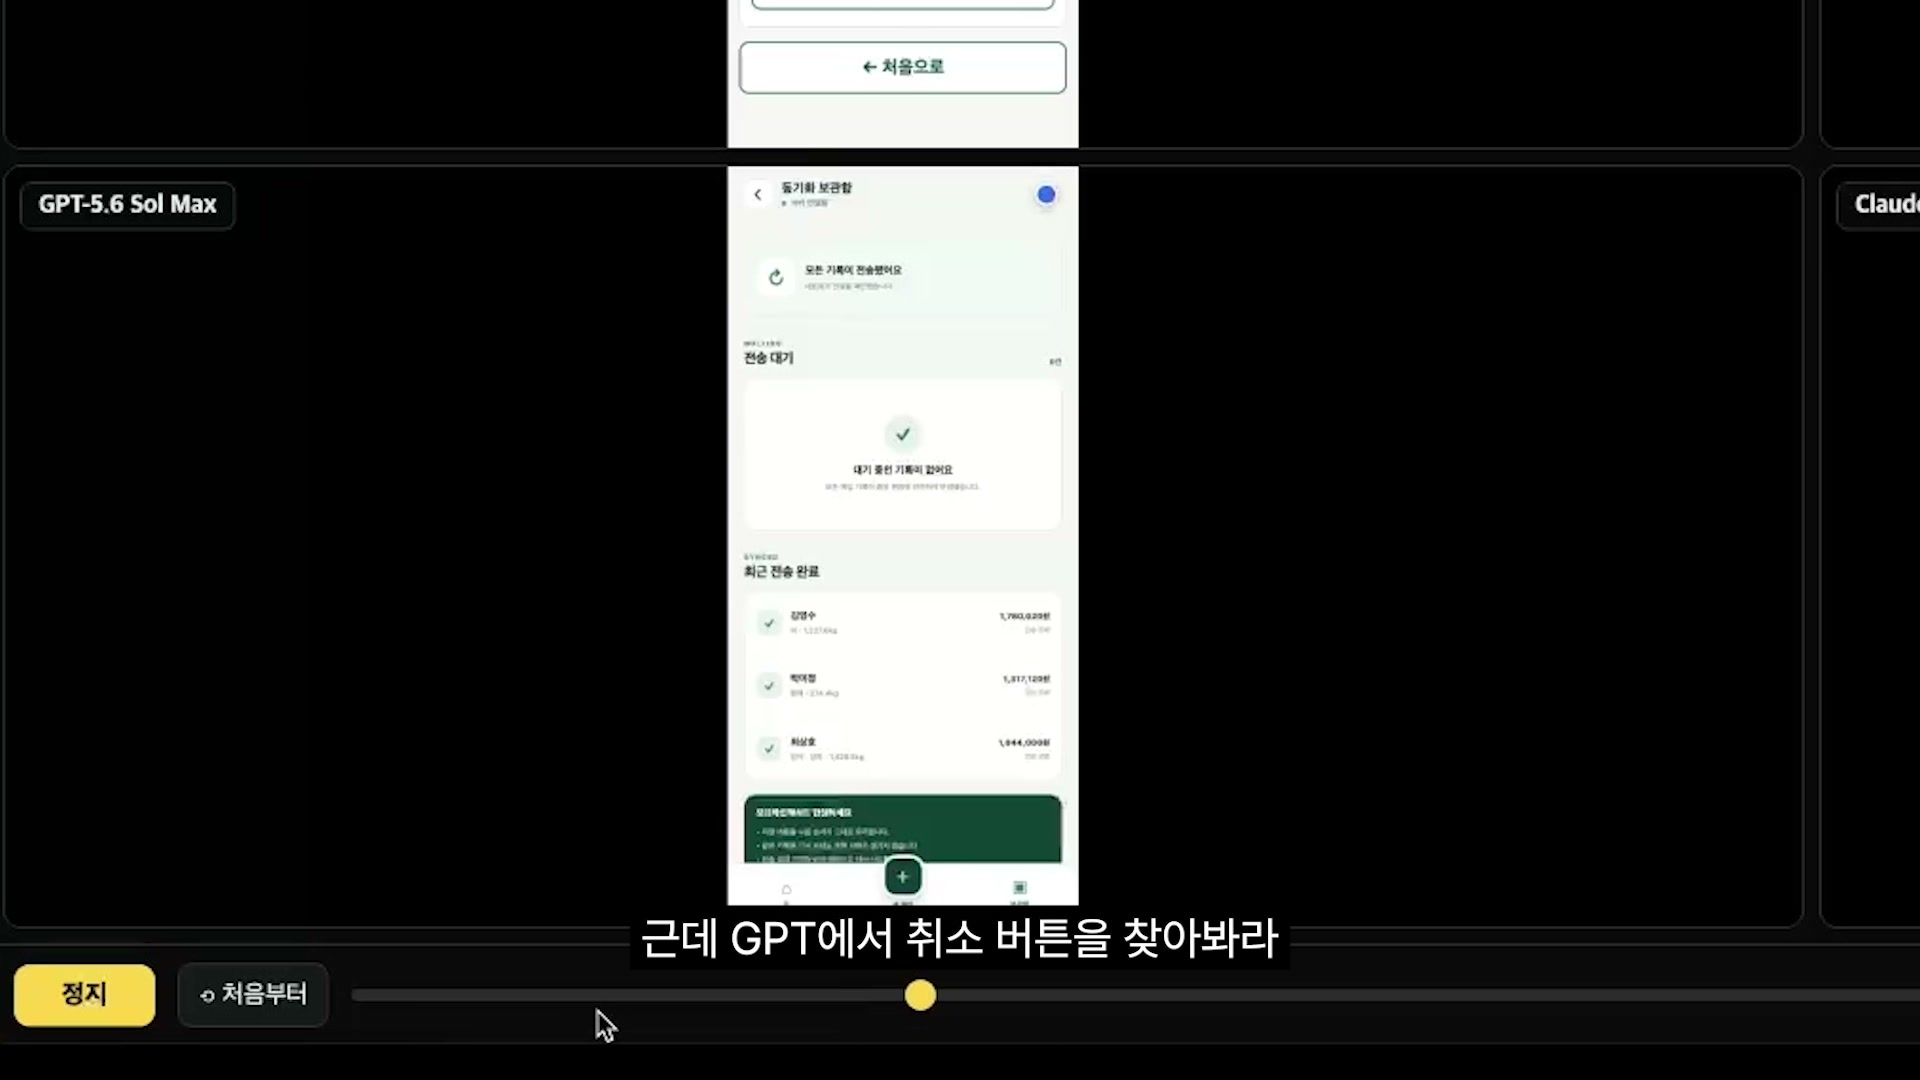
GPT 모바일 앱의 동기화 보관함. 기록은 남지만 취소로 들어가는 버튼이 없습니다.
웹에서 바꾼 가격이 앱에는 반영되지 않았습니다
센터 화면에서 감자 가격을 810원에서 812원으로 바꾸자 저장 완료 문구가 떴습니다. 그런데 현장 모바일 앱의 매입 단가는 여전히 810원이었습니다. 이 상태로 2kg을 입력하면 금액이 틀리게 계산돼요.
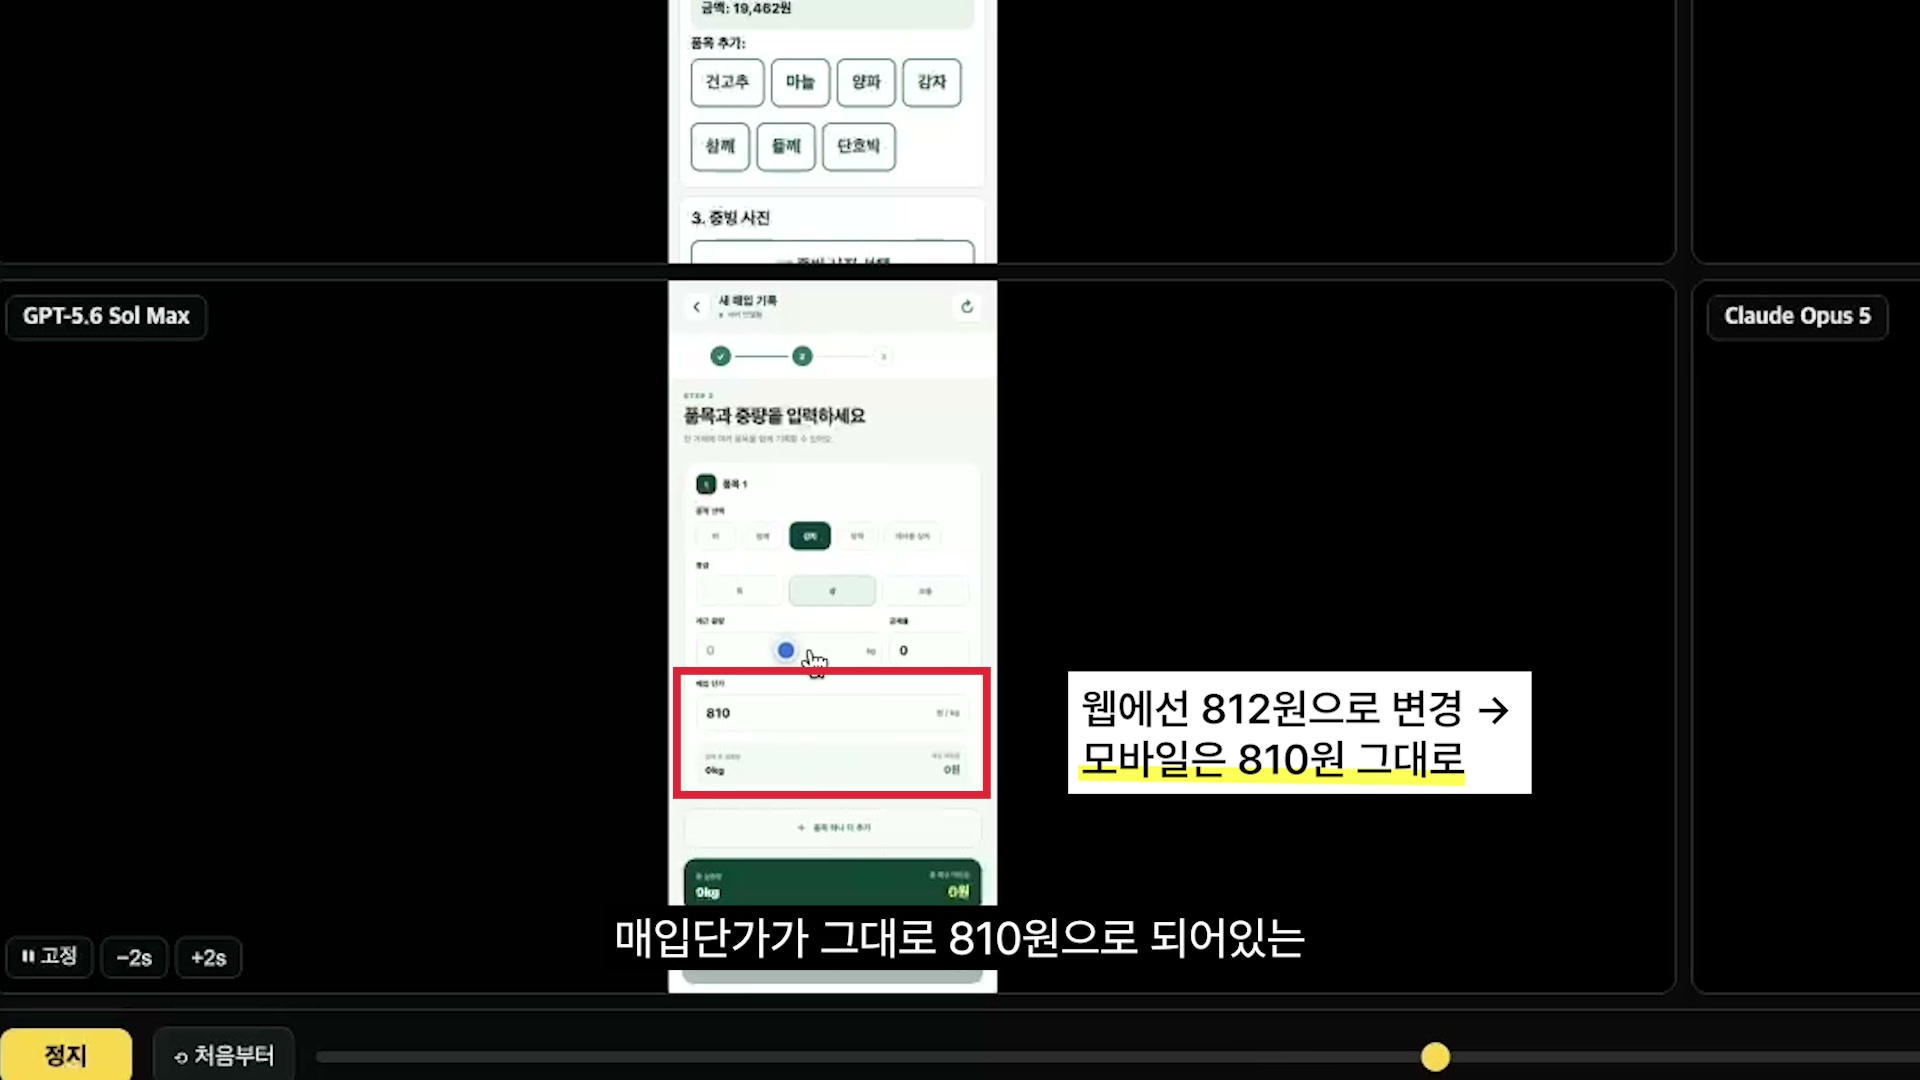
웹에서는 812원으로 바뀌었지만 GPT 모바일 앱의 매입 단가는 810원 그대로입니다.
그렇다면 화면에 공을 들인 만큼 서버 쪽이 밀린, 일종의 맞바꿈으로 봐야 할까요? 저희도 촬영하며 같은 질문을 했지만, 결론은 달랐습니다. 프롬프트는 디자인이 아니라 출시할 수 있는 구현을 요구했으니, 이건 취향이 아니라 요구사항을 지켰느냐의 문제입니다.
Opus 결과물: 통과한 장면과 막힌 장면
권한 밖 화면은 열리지 않았습니다
같은 시나리오에서 Opus 결과물은 로그인부터 요구했고, 로그인한 계정으로 권한 밖 페이지에 들어가자 "요청한 화면을 찾을 수 없습니다"라는 안내가 떴습니다. 상단 탭도 역할별로 나뉘어 있었어요. 앞서 세션 기록에서 Opus가 스스로 고쳤던 로그인과 접근 제한 버그가, 실제 결과물에서도 제대로 고쳐져 있었던 겁니다.
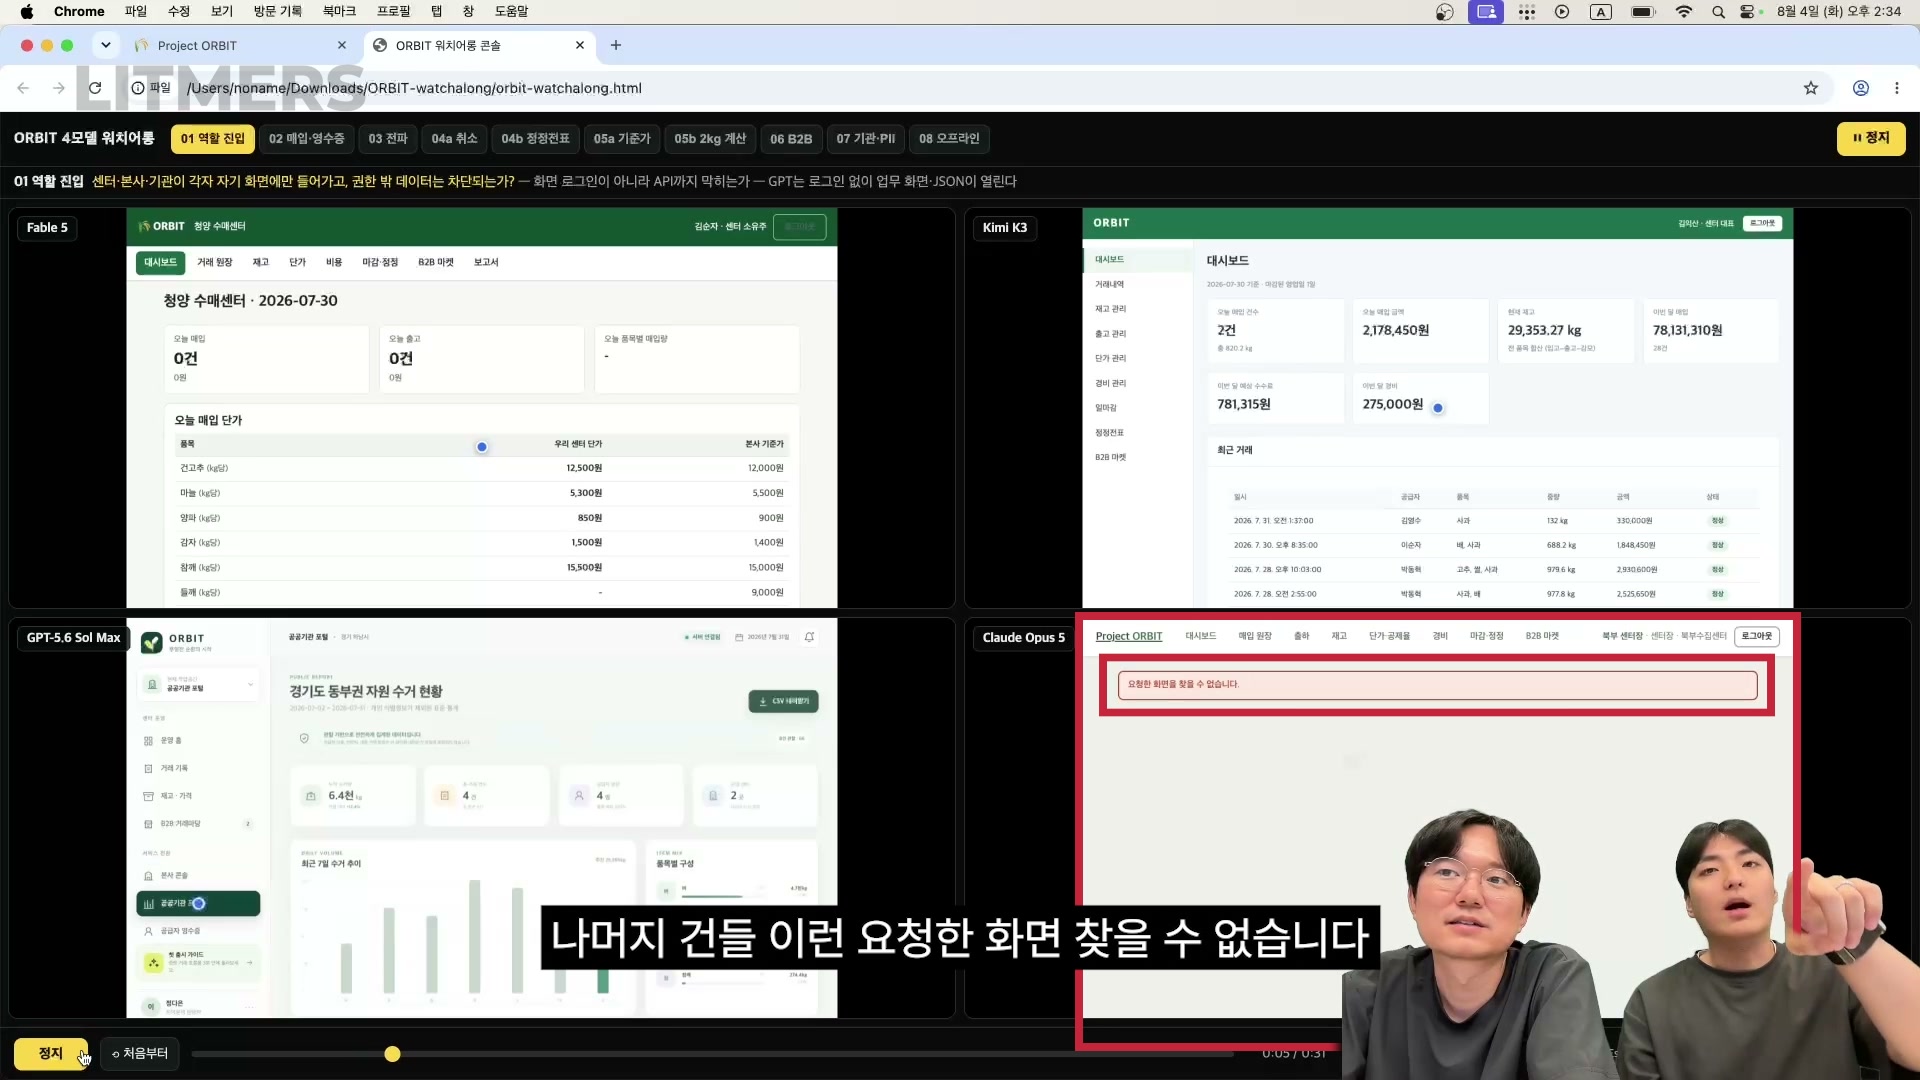
권한 밖 페이지에 들어가자 Opus 결과물은 "요청한 화면을 찾을 수 없습니다"로 막았습니다.
45분 취소는 사유와 함께 기록됐습니다
GPT 앱에 없던 취소 버튼이 Opus 모바일 앱에는 있었습니다. 거래를 고르고 사유를 적어 확정하면 취소 기록이 남습니다. 눈에 띄는 기능은 아니지만, 발주자가 검수할 때 먼저 확인하는 건 대개 이렇게 요구사항 문서에 적힌 규칙이 그대로 구현됐는지예요.
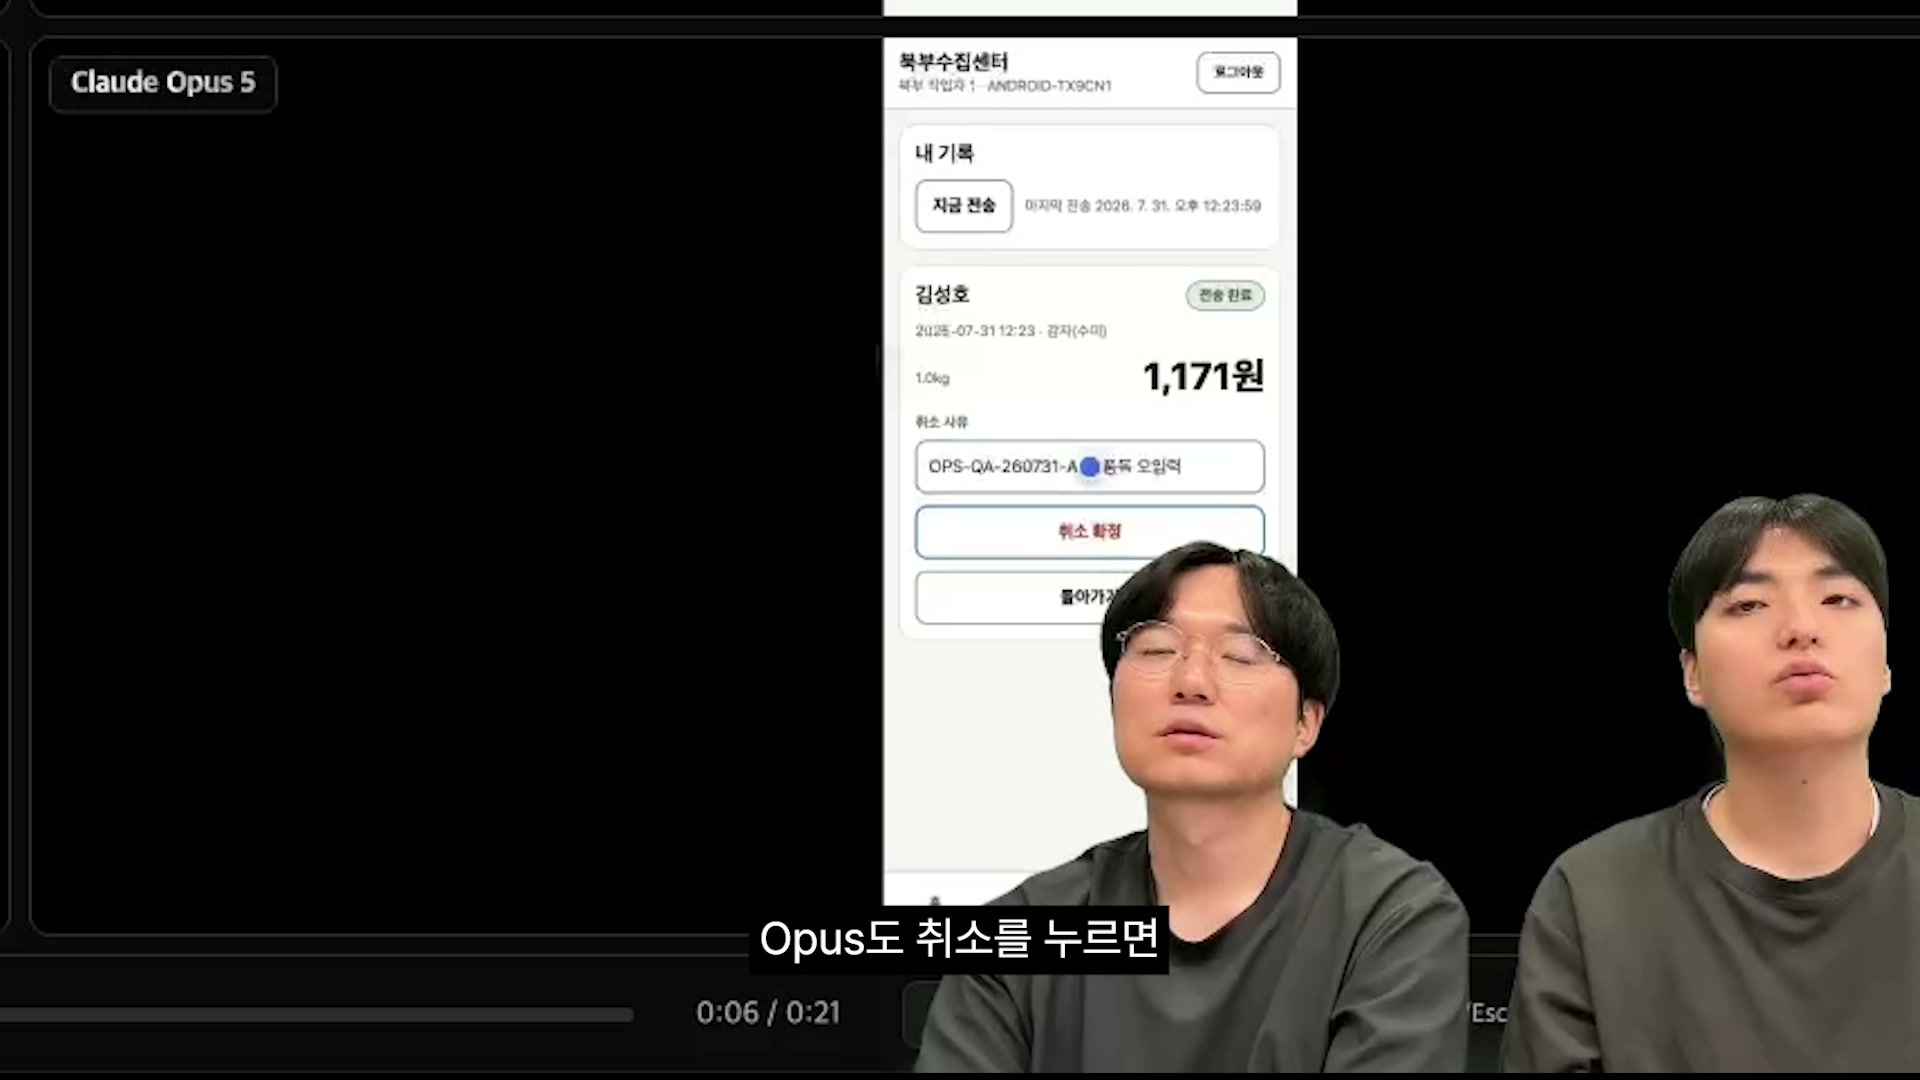
Opus 모바일 앱의 거래 취소 화면. 사유를 입력하고 확정하면 취소 기록이 남습니다.
마감 후 정정은 네 제품 중 Opus만 해냈습니다
회계에서 마감된 거래는 직접 고치지 않고, 바뀐 수량과 금액과 사유를 별도의 정정 전표로 남기는 게 원칙입니다. Opus는 소수점 수량(-0.2kg)과 금액(-240원)까지 포함해 이 과정을 끝까지 처리했고, 네 제품 중 이 장면을 통과한 건 Opus뿐이었습니다. 이 장면에서 다른 모델이 어떻게 막혔는지는 Fable 5 vs Opus 5 실측 글에서 자세히 다뤘습니다.
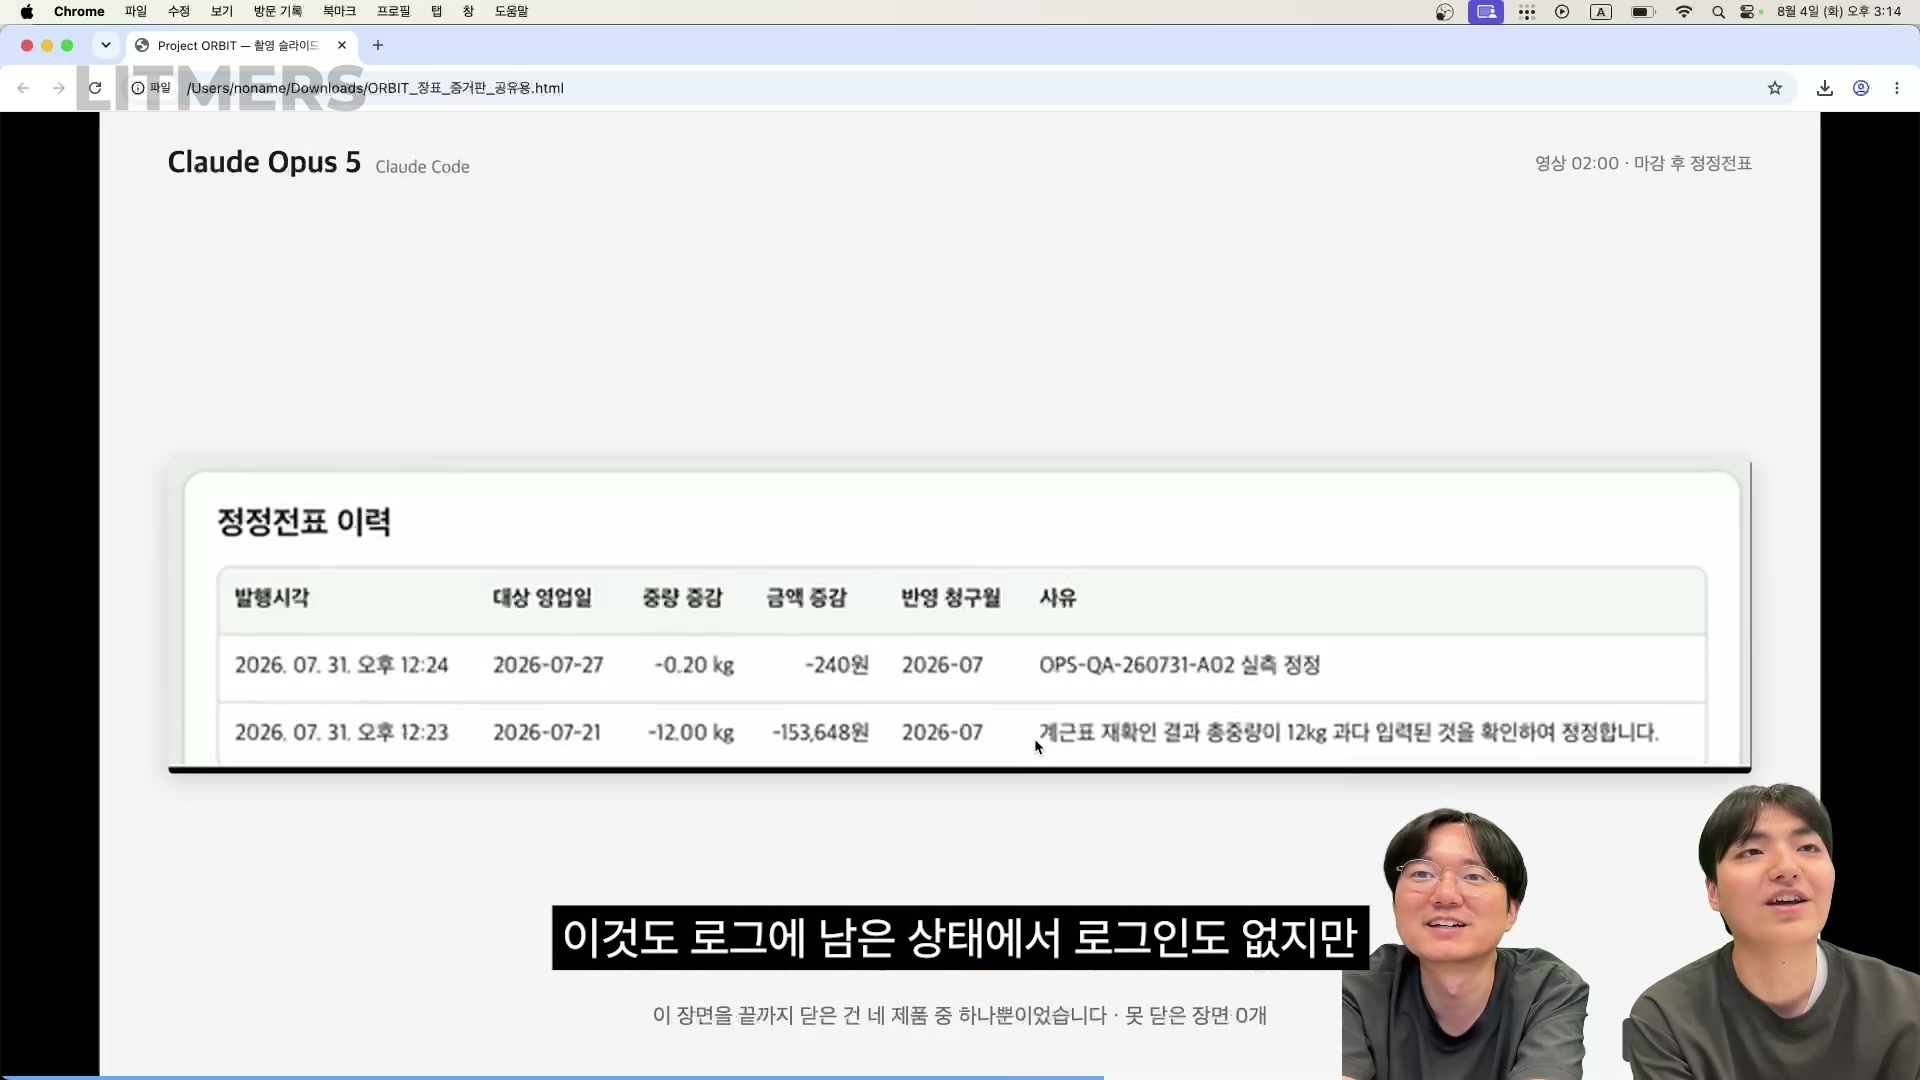
마감 후 정정 시나리오의 Opus 결과물. 원본은 그대로 두고 변경량과 사유가 이력으로 남습니다.
오프라인 복구는 Opus도 해내지 못했습니다
인터넷이 끊긴 현장에서 거래를 보관했다가, 연결이 돌아오면 중복 없이 전송하는 시나리오입니다. 이 장면은 네 제품 모두 '부분' 판정을 받았습니다. 시연에서는 오히려 GPT와 Kimi가 오프라인 대기열 화면까지 보여 줬고, Opus와 Fable은 전송 대기 상태에서 멈췄습니다. Opus가 10개를 다 통과하지 못하고 9개에 그친 건 이 장면 때문입니다.
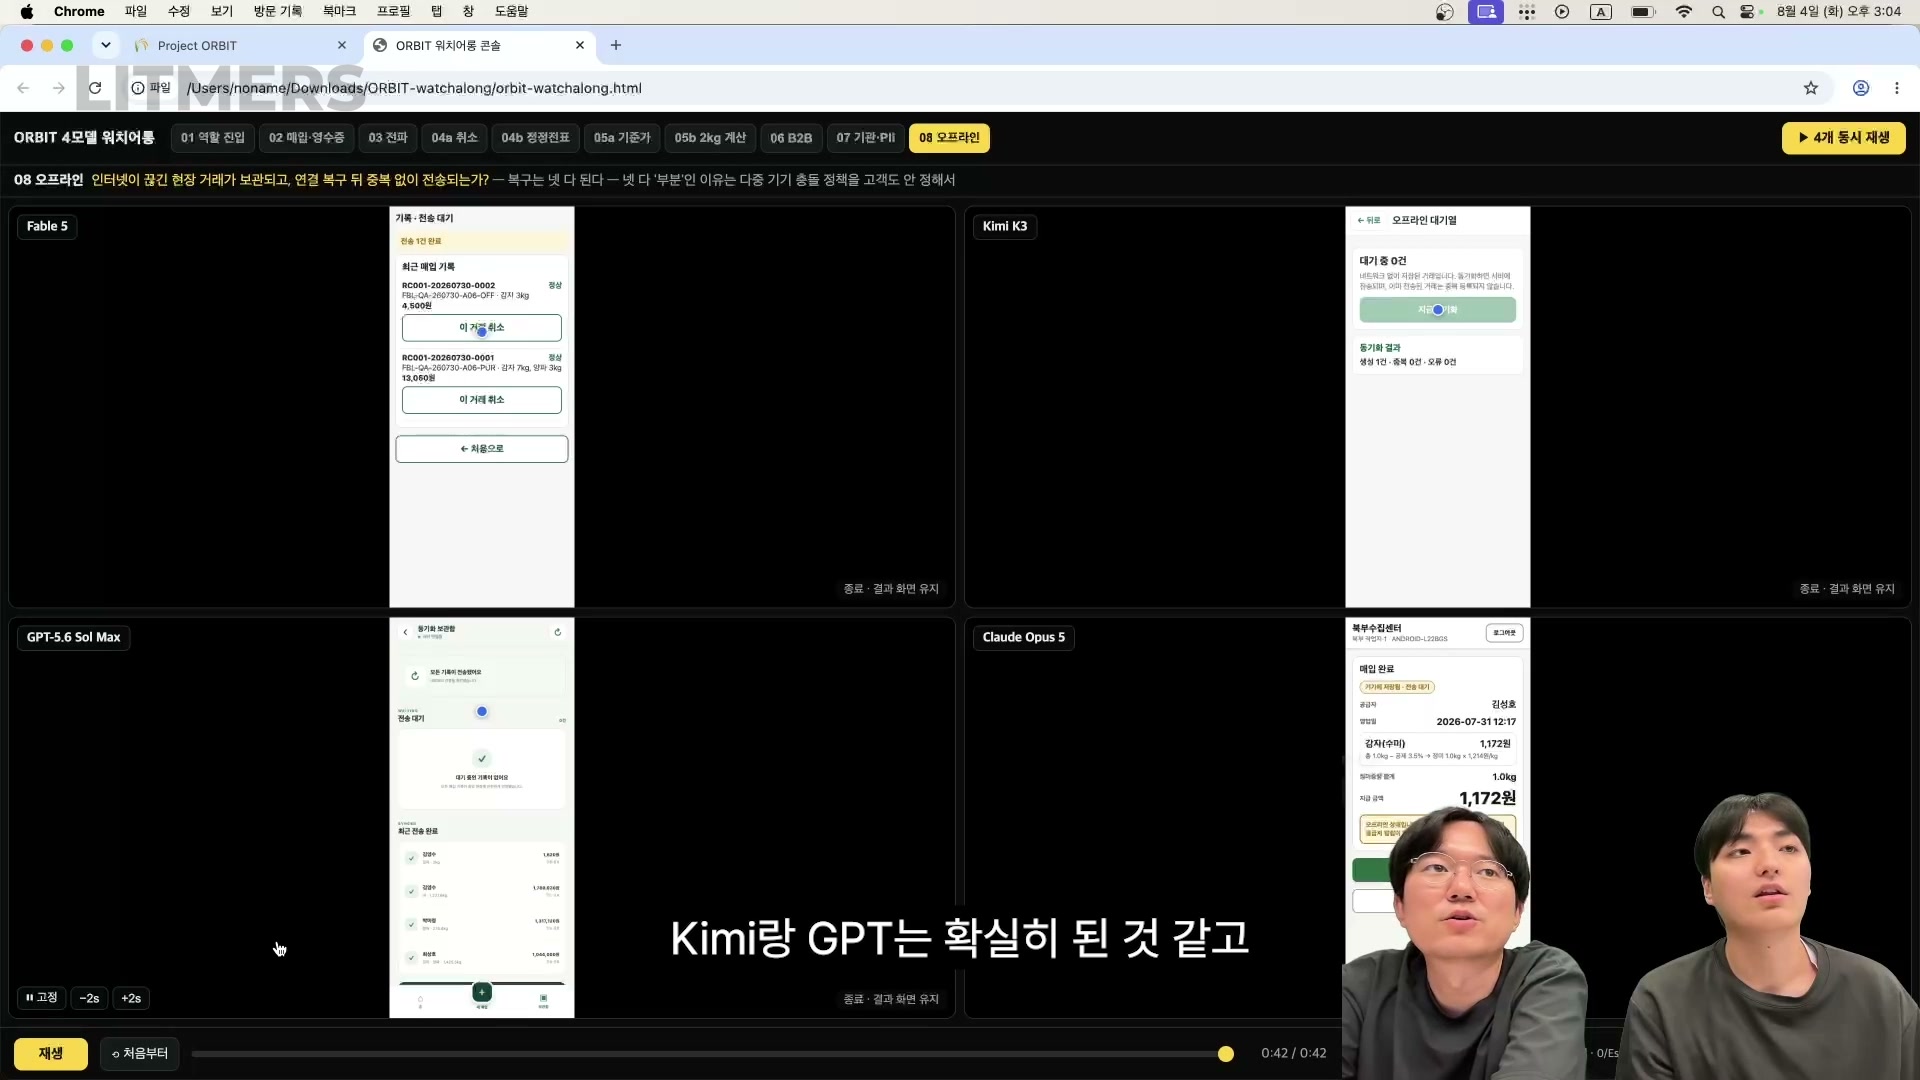
오프라인 시나리오 시연. GPT와 Kimi는 대기열 화면까지 보여 줬고 Opus와 Fable은 전송 대기에서 멈췄습니다.
네 제품 모두 이 장면을 끝내지 못한 데는 이유가 있었습니다. 여러 기기가 같은 거래를 올렸을 때 어느 쪽을 인정할지, 고객이 정책을 정해 두지 않았거든요. 이런 요구는 개발자가 추측해서 구현할 게 아니라 발주자에게 되물어야 하는 부분입니다.
판정 결과: GPT 0개, Opus 9개
실무 시나리오 10개를 처음부터 끝까지 실행해 마지막 결과까지 맞게 나오는지를 기준으로 판정한 결과, GPT-5.6 Sol은 통과 0개, Claude Opus 5는 통과 9개였습니다. 이 숫자는 결과물의 품질 점수가 아니라, 이번 실험의 장면 10개 가운데 끝까지 해낸 장면이 몇 개인지를 센 것입니다. GPT의 0개도 아무것도 동작하지 않았다는 뜻은 아닙니다. 매입 등록, 대시보드 반영, 정정 전표, 오프라인 네 장면은 기능은 동작했지만 마지막 결과가 맞는지까지는 확인되지 않아 '부분' 판정을 받았습니다.
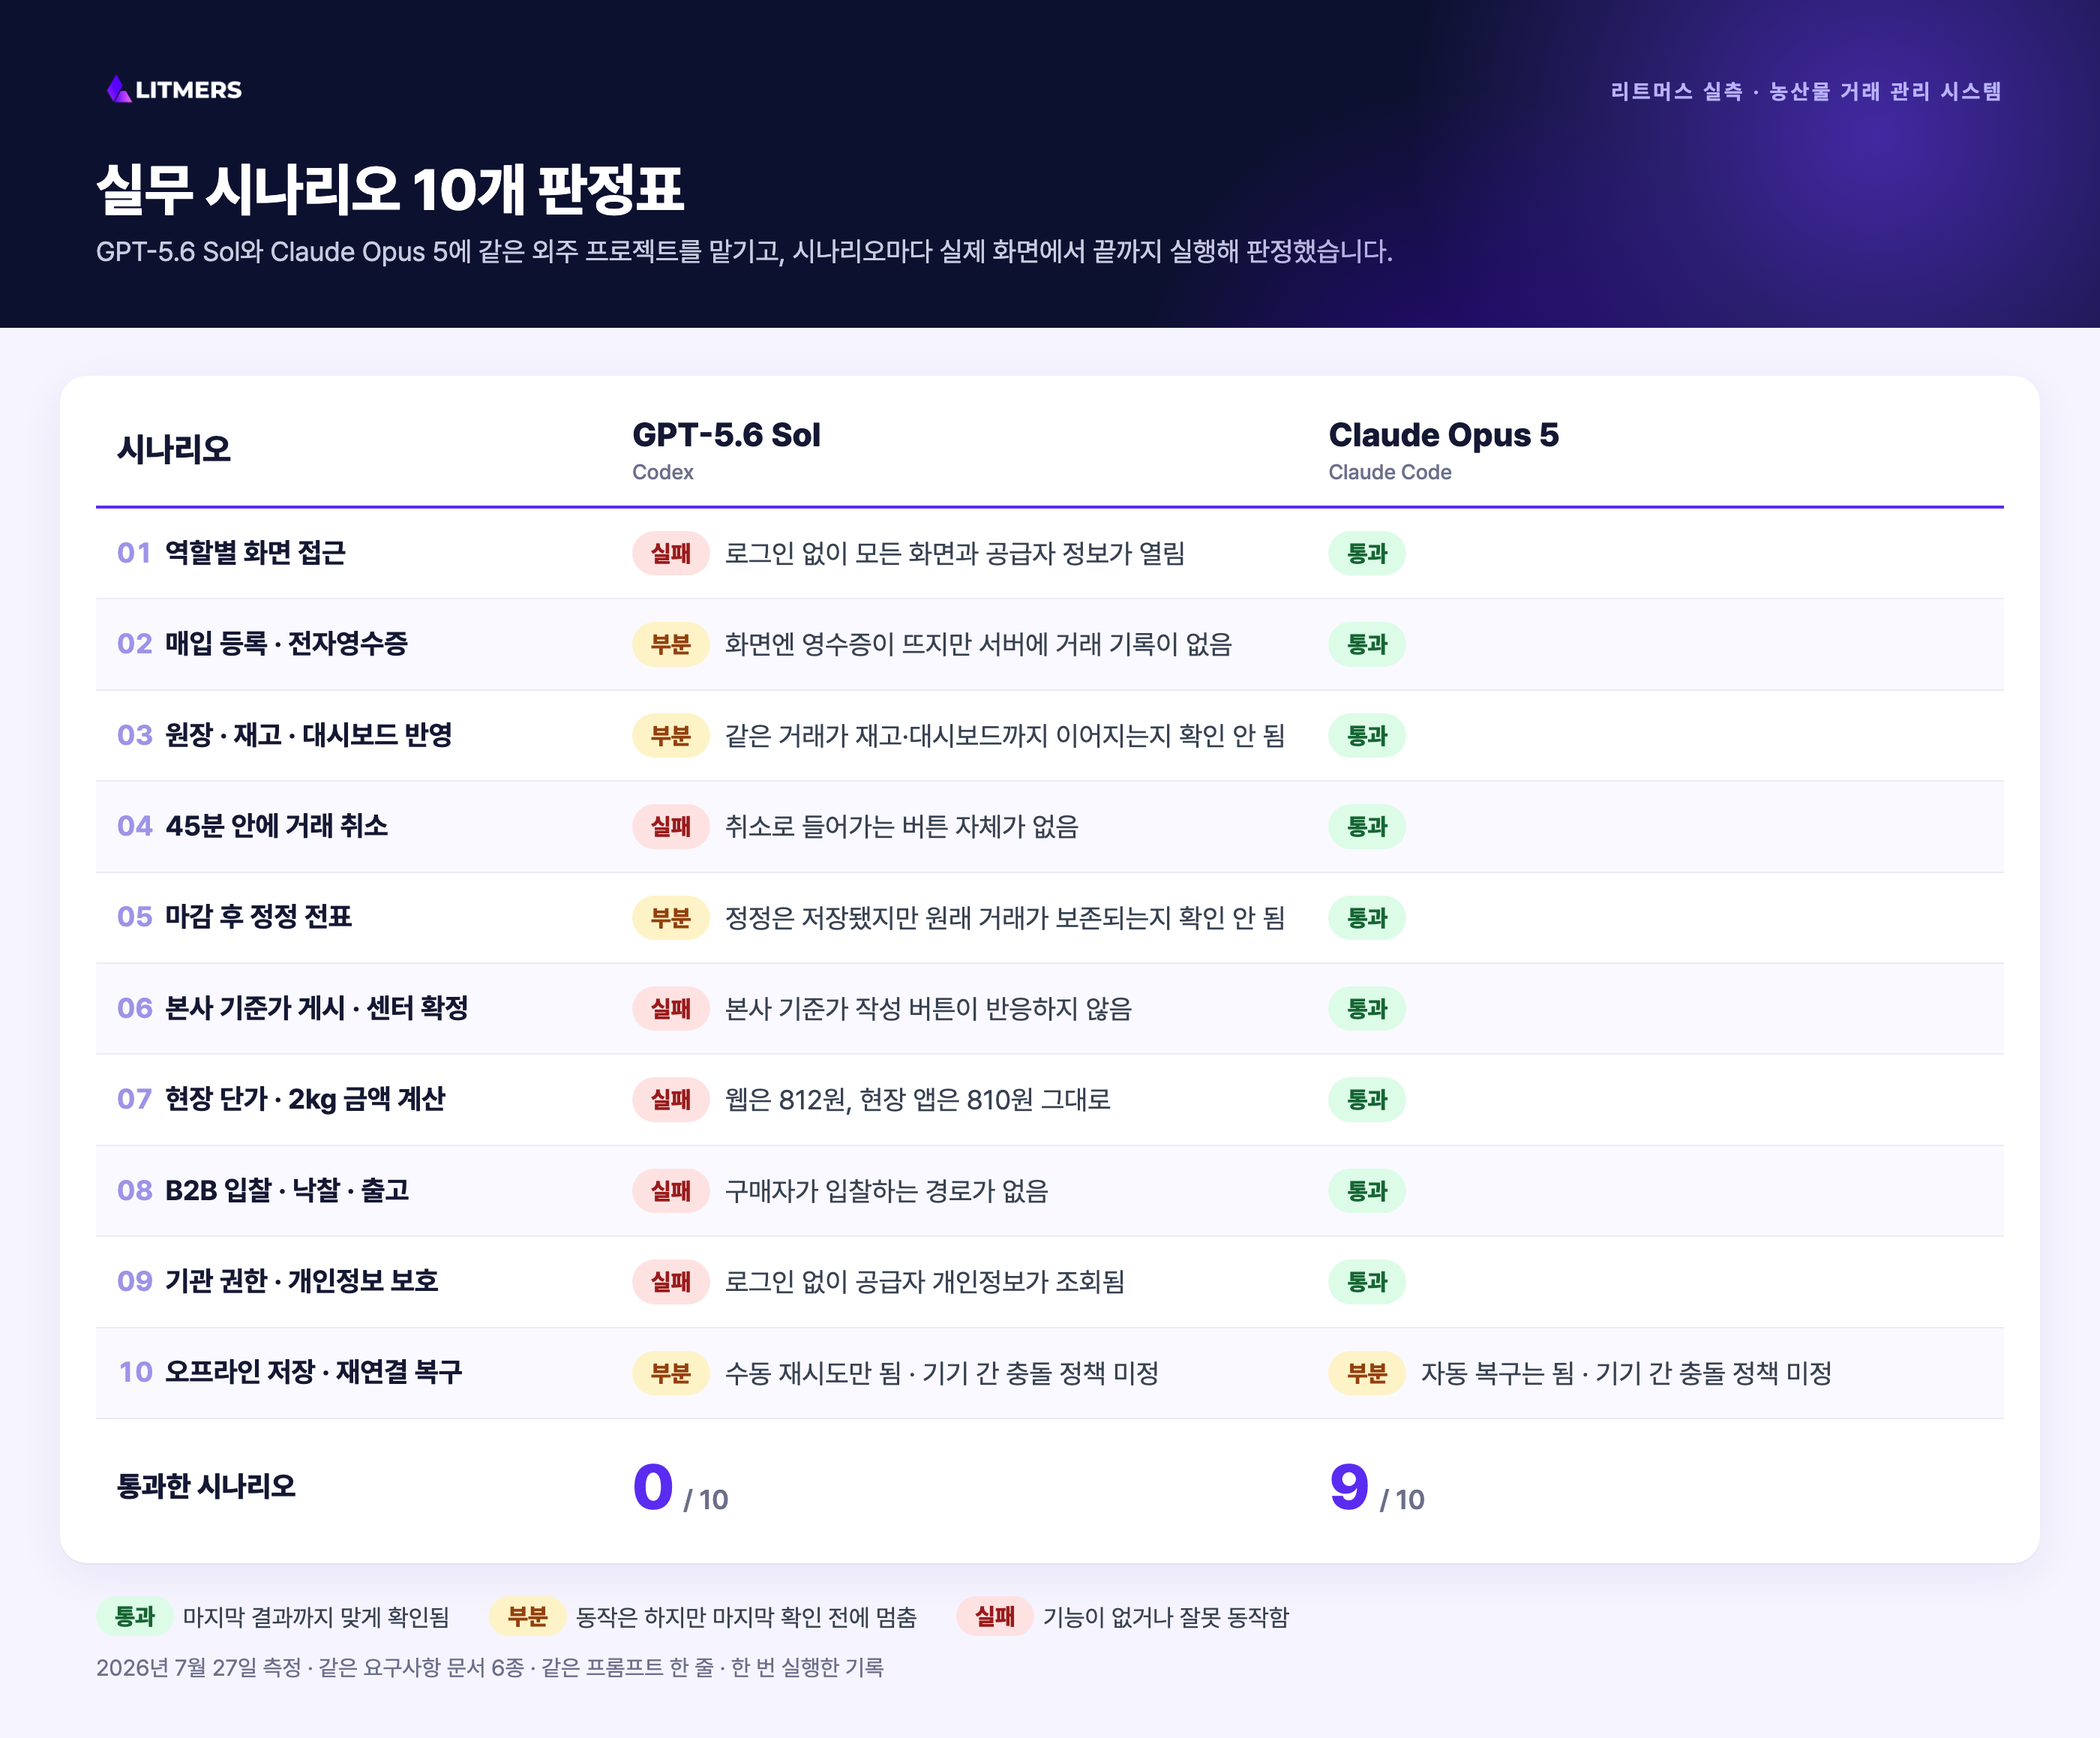
GPT-5.6 Sol과 Claude Opus 5의 판정표 · 2026년 7월 27일 측정. 세로는 시나리오 10개, 가로는 두 제품이고, 부분·실패 칸에는 어디서 막혔는지를 적었습니다. GPT의 부분 4개는 기능은 동작했지만 마지막 확인 전에 멈춘 경우입니다.
코드를 많이 쓴 쪽이 더 많이 통과한 것도 아니었습니다. 늘어난 코드 줄 수를 가로축, 통과한 장면 수를 세로축에 놓으면 GPT는 약 1만 3천 줄에 0개, Opus는 약 1만 6천 줄에 9개입니다.
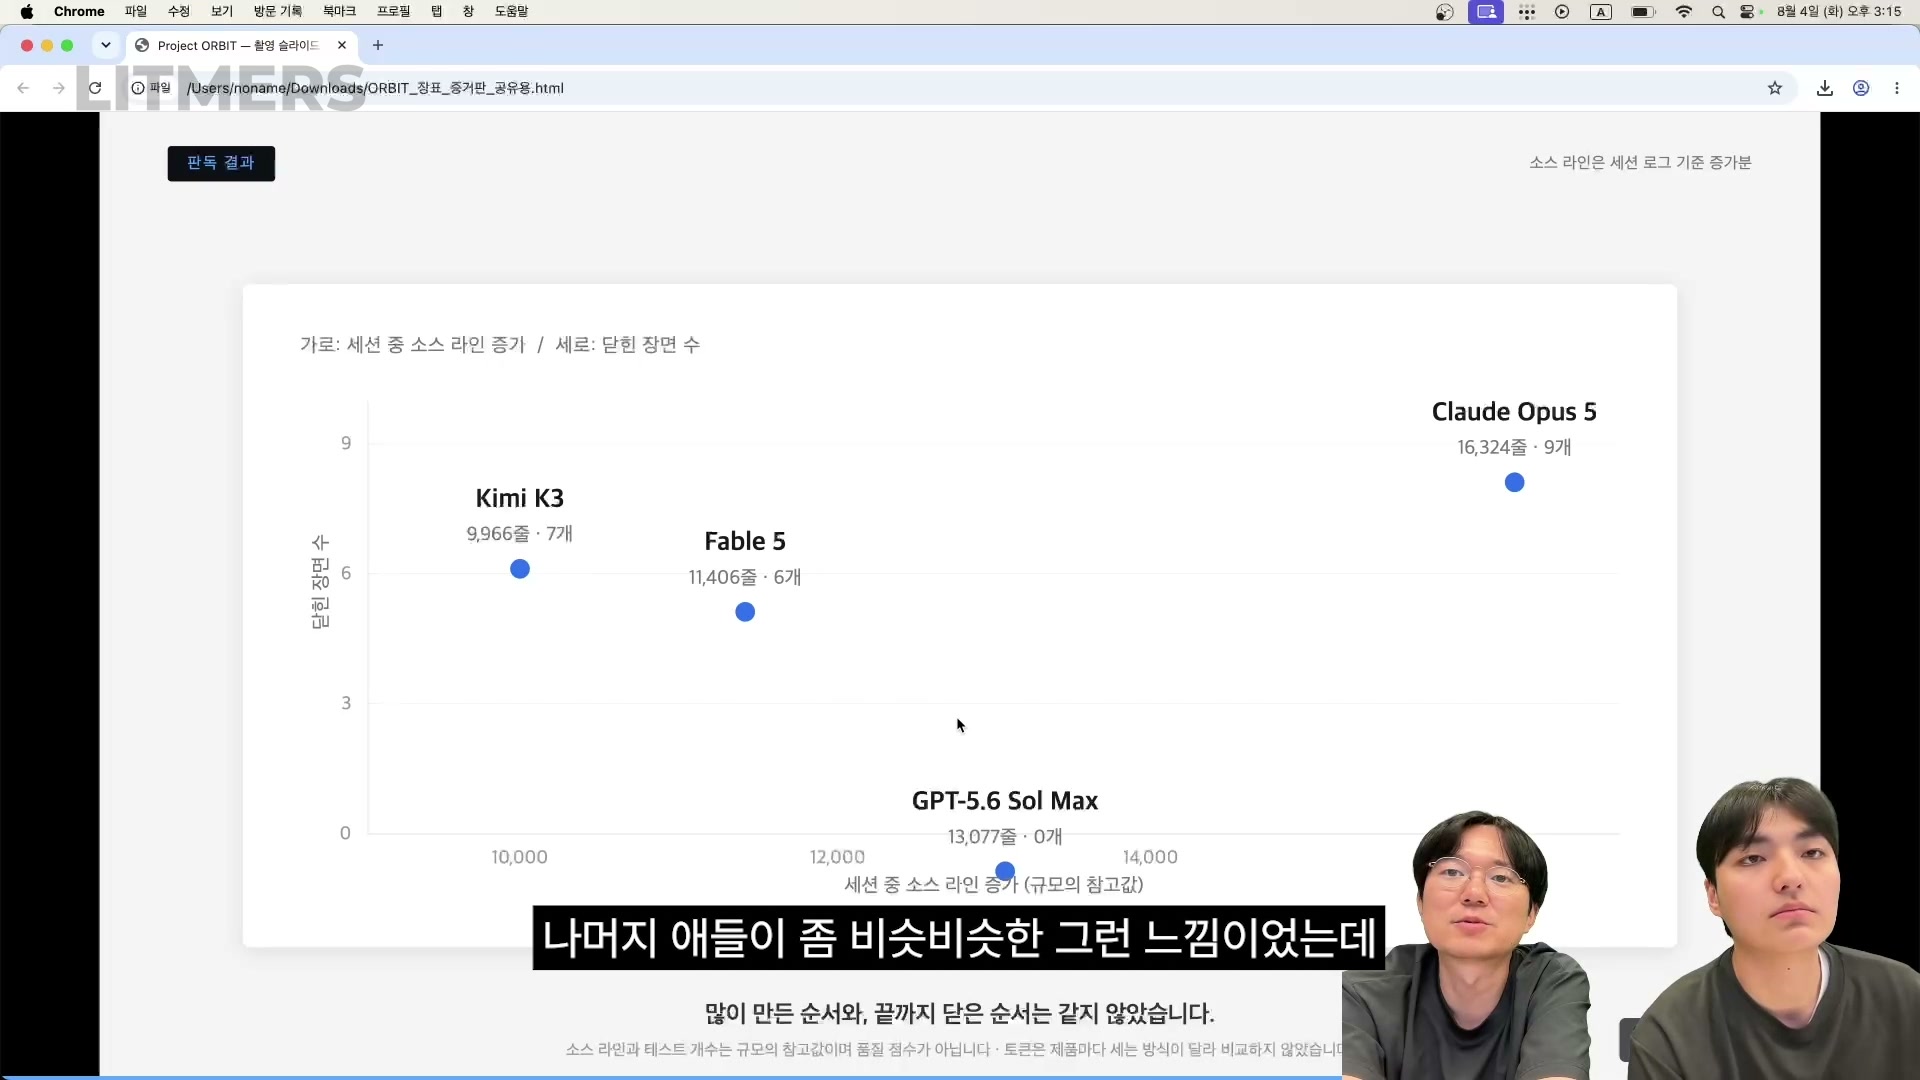
가로축은 세션 중 늘어난 코드 줄 수, 세로축은 통과한 장면 수. 코드 줄 수는 규모 참고값이지 품질 점수가 아닙니다.
이 기록이 말해 주는 범위도 분명히 해 두겠습니다. 저희가 확인한 것은 같은 프로젝트를 두 제품에 한 번씩 맡겼을 때 장면 10개가 어떻게 끝났는지입니다. Codex 세션 기록에 보조 에이전트를 띄우지 말라는 지시문이 있었던 것도 봤지만, 이 지시가 결과에 얼마나 영향을 줬는지는 따로 확인하지 않았습니다. 같은 실행을 여러 번 반복하거나 다른 프로젝트로 돌려 보지도 않았습니다. Codex는 주어진 지시문을 충실히 따르는 편이라, 시스템 프롬프트나 AGENTS.md를 다르게 썼다면 결과도 달라졌을 수 있습니다.
실무에서는 단계별로 나눠 씁니다
두 제품의 성향을 정리하면 이렇습니다.
- GPT-5.6 Codex는 화면을 빨리 보여 줄 때: 요구사항을 눈에 보이는 화면으로 만들어 이해관계자의 피드백을 받는 단계, 프론트엔드 시안이 필요한 단계
- Claude Opus 5는 출시 전 마무리할 때: 로그인, 취소, 정정처럼 막고 되돌리는 흐름까지 확인해야 하는 개발
- 둘을 가른 건 완료 전 재확인: 코드량이나 작업 시간이 아니라, 다 됐다고 보고하기 전에 결과물을 다시 눌러 봤는지
촬영 막바지에 저희가 떠올린 조합도 같은 방향이었습니다. 1차 출시본의 화면은 GPT에게 맡기고, 구현과 확인은 다른 모델에 맡기는 조합입니다. 이 실험 뒤로 저희는 "어느 모델이 더 좋은가"보다 "이 프로젝트의 지금 단계에 필요한 게 화면인가, 마감인가"를 먼저 묻습니다.
"완료 판정은 새 데이터를 만들 때가 아니라, 잘못된 데이터를 규칙대로 되돌릴 수 있을 때 합니다."
리트머스는 이 결과를 이렇게 씁니다
리트머스는 새 모델이 나올 때마다 실제 프로젝트 자료로 이렇게 검증하고, 그 결과에 따라 화면이 필요한 단계와 마감이 필요한 단계에 서로 다른 모델을 배치합니다. 어느 단계든 마지막 검수는 사람이 현장 시나리오로 합니다. 우리 프로젝트에는 어떤 조합이 맞을지 궁금하시다면, 무료 견적 상담에서 함께 검토해 드립니다.
Codex가 지시문을 이렇게 충실히 따른다면, 다음으로 궁금한 건 무엇을 어떻게 지시하느냐일 겁니다. 설치부터 커맨드, 스킬, AGENTS.md 작성법까지는 아래 글에 정리해 두었습니다.
코덱스 CLI 완벽 가이드: 설치 방법부터 커맨드·스킬·AGENTS.md까지 총정리
네 모델 전체의 실험 과정과 열 장면의 판정 근거는 영상에서 보실 수 있습니다.