출시 2주, 써 본 사람들은 "이번엔 확실히 좋아졌다"고 말합니다
"Opus 5.5가 Opus 5.0에 비해 간만에 장점만 존재하는 버전업이라는 생각이 들 정도로 쾌적합니다." 출시 2주째인 10월 6일, 한 국내 개발자가 자기 블로그에 남긴 평가입니다. Anthropic이 9월 22일 공개한 Claude Opus 5.5는 가격을 20% 내리면서도 성능을 끌어올렸고, 2주 동안 쌓인 후기도 대부분 이번 버전업이 확실히 체감된다는 쪽입니다. 출시 당일 해커뉴스 스레드는 1,806포인트를 모았고, 미국 미디어 Every는 사전 테스트 후기에 "Opus 5.5가 Codex로 떠났던 사람들을 Claude로 다시 데려오고 있다"는 제목을 달았습니다. 이 글에서는 공식 문서로 무엇이 바뀌었는지 정리한 뒤, 2주 동안 나온 실사용 후기로 어디서 좋아졌고 무엇을 챙겨야 하는지 따라갑니다.
Opus 5.5에서 무엇이 바뀌었나
Claude Opus 5.5는 Anthropic의 상용 최상위 라인인 Opus의 신형이고, API 모델 ID는 claude-opus-5-5입니다. 7월 24일 나온 Opus 5 이후 두 달 만의 후속작입니다. 위로는 최고 등급 모델 Fable 5.1이 있고, 아래로는 9월 28일 나온 Sonnet 5.5가 있습니다. Anthropic은 발표문에서 Opus 5.5가 대부분의 작업에서 Fable 5.1 수준의 성능을 내면서, Opus 5보다 운영 비용은 40% 적게 들고 출력 속도는 30% 이상 빠르다고 설명했습니다.
스펙은 컨텍스트 100만 토큰, 최대 출력 12만 8천 토큰이고, 학습 데이터는 2026년 6월까지입니다. 추론(thinking)은 항상 켜져 있고 작업 난도에 따라 생각하는 양을 스스로 조절합니다. 개발자 입장에서 눈여겨볼 변화는 추론 강도(effort)의 기본값입니다. Opus 5에서는 따로 지정하지 않으면 high로 돌았는데, Opus 5.5는 medium이 기본입니다. 같은 코드로 모델 이름만 바꿨는데 결과가 달라졌다면 이 기본값부터 확인해 보셔야 합니다.
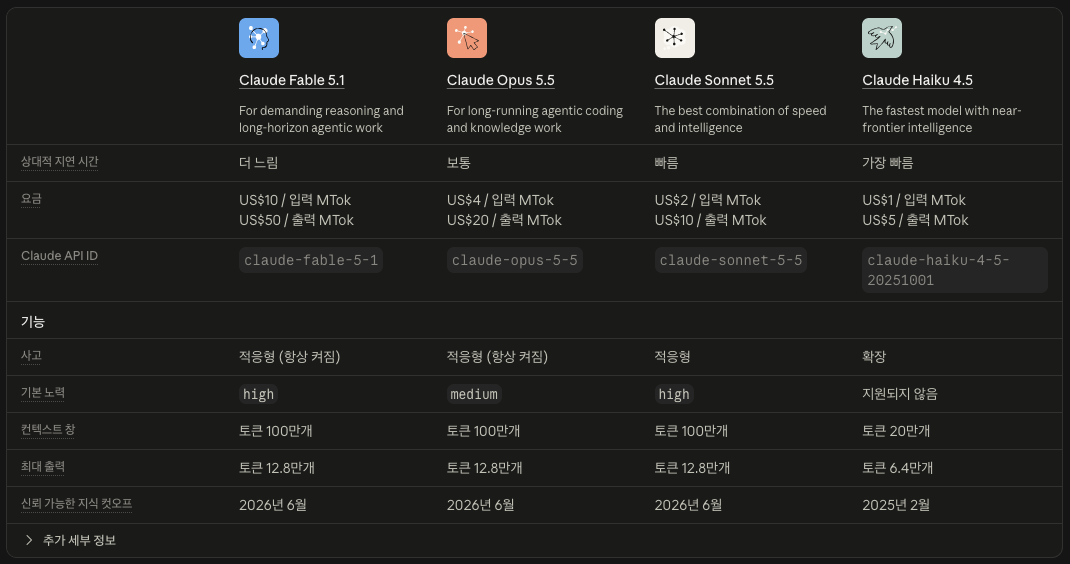
Claude 공식 문서의 모델 비교표로, 기본 추론 강도 칸에서 Opus 5.5만 medium인 것을 볼 수 있습니다. 경량 모델은 아직 Haiku 4.5입니다. 2026년 10월 6일 캡처. (출처 : Anthropic, 2026)
Claude 모델 비교표 공식 문서 바로가기
가격: 정가 20% 인하, 캐시 읽기는 60% 인하
Opus 5.5의 가격은 100만 토큰당 입력 $4, 출력 $20으로 Opus 5의 $5/$25보다 20% 낮습니다. 인하 폭이 더 큰 쪽은 캐시입니다. 한 번 읽힌 입력을 다시 읽을 때 붙는 캐시 읽기 요금이 $0.50에서 $0.20으로 60% 내려갔습니다. 같은 문서와 코드를 반복해서 읽는 에이전트 작업에서는 이 항목이 청구액의 상당 부분을 차지하기 때문에, 체감 인하 폭은 정가 20%보다 클 수 있습니다.
나머지 요금도 정리해 두면 이렇습니다. 5분 캐시 저장은 $5, 1시간 캐시 저장은 $8입니다. 결과를 나중에 받는 배치(Batch) 처리는 $2/$10으로 절반이고, 응답을 더 빨리 받는 Fast 모드는 $8/$40으로 두 배입니다. 위 가격은 10월 6일 공식 가격 문서에서 다시 확인했습니다.
구독 사용자 쪽 변화도 있습니다. Anthropic은 출시와 함께 Pro·Max·Team 요금제의 5시간 사용량 한도를 올리고, 원하는 때 한 번 쓸 수 있는 사용량 초기화를 제공한다고 발표했습니다. 같은 날 나온 GPT-6 Sol과의 가격·성능 비교는 Claude Opus 5.5 vs GPT-6 Sol 비교 글에 따로 정리해 두었습니다.
Claude 공식 가격 문서 바로가기
벤치마크: 발표 수치와 외부 측정은 다르게 읽어야 합니다
Anthropic이 앞세운 수치는 터미널에서 실제 개발 작업을 수행하는 벤치마크 Terminal-Bench 4.0입니다. 발표 기준 Opus 5.5는 66.4%로, Fable 5.1(55.8%)과 Opus 5(52.3%)를 앞섰습니다. 화면을 보고 컴퓨터를 조작하는 OSWorld 2.1에서는 81.8%, 고난도 지식 문제 모음인 HLE에서는 67.7%를 발표했습니다. 대신 Opus 5부터는 SWE-bench Verified 점수를 공개하지 않고 있습니다.
외부 기관이 같은 벤치마크를 직접 돌린 결과는 발표치보다 낮았습니다. 독립 평가 기관 Artificial Analysis는 Terminal-Bench 4.0을 자체 측정해 59.6%를 얻었고, 이는 OpenAI의 최상위 모델 GPT-6 Astra와 같은 수준입니다. 측정 환경이 다르면 점수가 이 정도 움직인다는 뜻이라, 발표 수치는 회사끼리 비교하는 용도보다 같은 회사의 이전 모델과 비교하는 용도로 읽는 편이 안전합니다. 같은 기관의 종합 지능 지수에서는 58점으로 기관 집계 사상 최고점을 받았습니다.
사용자 투표로 순위를 매기는 LMArena 텍스트 순위는 출시 직후 1위로 알려졌지만, 10월 2일 기준으로는 4위입니다. 9월 30일 Google이 낸 Gemini 4 Argon이 1,525점으로 1위에 올랐고, Opus 5.5는 1,504점입니다. 다만 2위부터 4위까지가 1,504~1,505점에 몰려 있고 오차 범위가 ±9점이라, 순위 숫자 자체에 큰 의미를 두기는 어렵습니다.
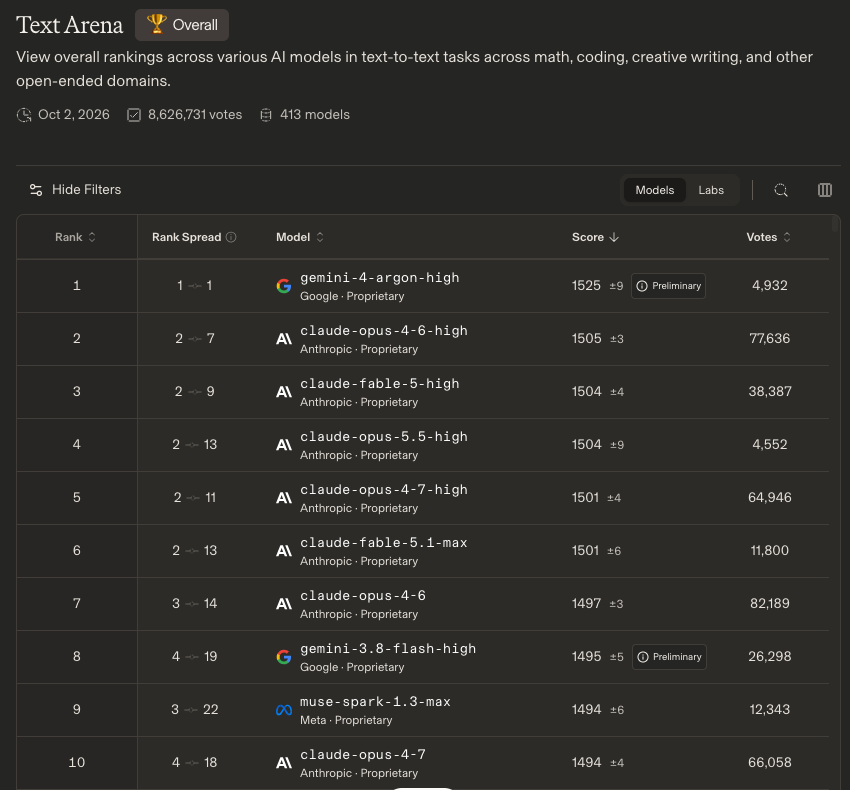
LMArena 텍스트 종합 순위표입니다. Score 칸의 ± 값이 오차 범위이고, Rank Spread 칸은 오차를 고려했을 때 가능한 순위 범위입니다. Opus 5.5는 4위지만 가능한 순위는 2~13위로 넓습니다. 2026년 10월 2일 집계. (출처 : LMArena, 2026)
LMArena 텍스트 순위표 바로가기
코드를 그대로 두어도 달라지는 세 가지
후기를 읽기 전에 알아 두면 좋은 공식 설명이 있습니다. Anthropic은 개발자 문서에 Opus 5에서 Opus 5.5로 바꿀 때 코드 변경 없이도 동작이 달라지는 지점을 따로 적어 두었습니다. Anthropic이 적어 둔 동작 차이 가운데 세 가지가 출시 후 나온 불만과 그대로 겹칩니다.
첫째는 앞에서 말한 기본 추론 강도입니다. 같은 요청이 high가 아니라 medium으로 돌기 때문에, 설정을 명시하지 않은 사용자는 "덜 생각한다"고 느낄 수 있습니다. 반대로 같은 강도에서는 Opus 5보다 턴마다 더 많이 생각한다는 설명도 함께 있습니다. 둘째는 작업 중간의 진행 메시지입니다. 도구를 호출하는 사이사이에 모델이 쓰는 짧은 메모가 이제 추론 블록으로 넘어가서, 기본 설정에서는 화면에 보이지 않습니다. 긴 작업 중에 모델이 멈춘 것처럼 보인다는 보고가 여기서 나왔습니다. 셋째는 안전 장치입니다. 기존 사이버 보안 분류기에 생물학 분류기가 더해져, 거절되는 요청의 범위가 넓어졌습니다.
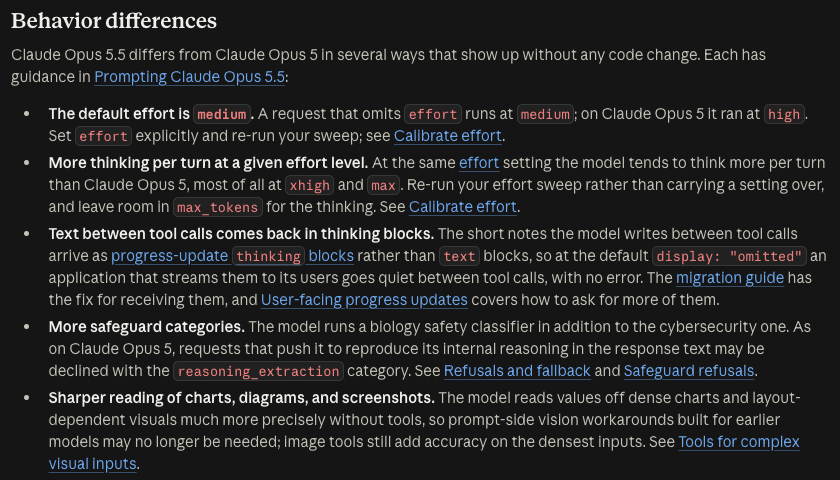
Opus 5.5 변경 사항 문서의 '동작 차이' 섹션입니다. 위에서부터 기본 추론 강도 medium, 같은 강도에서 더 많은 추론, 도구 호출 사이 메시지의 추론 블록 전환, 안전 분류기 추가가 적혀 있습니다. 2026년 10월 6일 캡처. (출처 : Anthropic, 2026)
What's new in Claude Opus 5.5 공식 문서 바로가기
Opus 5.5 실제 후기: Codex로 떠났던 개발자들이 돌아오고 있습니다
가장 공들인 후기는 Every 팀의 사전 테스트입니다. 테스터 네 명이 출시 전 일주일 동안 코딩, 디자인, 글쓰기 작업을 Opus 5.5에 맡겼습니다. 그동안 OpenAI의 Codex로 옮겨 갔던 테스터들 가운데, Opus 5.5를 써 본 뒤 다시 Claude로 돌아오는 사람이 생겼습니다. Claude를 떠났던 디자이너 Tyler Nishida는 "이번 주에만 대여섯 번은 입이 떡 벌어졌다, 다시 마음을 빼앗겼다"고 썼습니다. 그는 직접 꾸린 에이전트 팀으로 골프 게임 하나를 2시간이 안 되는 시간에 만들었습니다.
개발자 Kieran Klaassen의 평가는 더 직접적입니다. 그는 Opus 5.5가 최고 등급 모델인 Fable 5.1만큼 좋고 때로는 더 낫다며, 매일 쓰는 주력 모델을 Fable 5.1에서 Opus 5.5로 바꿨습니다. 그가 짠 Ruby 코드는 초당 427건의 요청을 처리했고, 지연 시간 목표 20개 중 17개를 맞췄습니다. Fable 5.1은 Opus 5.5보다 정가가 2.5배 비싼 모델이라, 같은 결과를 훨씬 싸게 얻게 된 셈입니다. 테스터 Mike Taylor는 Opus 5의 거슬리는 말버릇이 지능은 그대로 둔 채 사라졌다고 평가했고, 지식 업무에서는 여전히 Codex를 더 많이 쓰는 CEO Dan Shipper도 토큰은 Claude 쪽에 훨씬 많이 쓰게 됐다고 밝혔습니다.
Every의 Opus 5.5 사전 테스트 후기 바로가기
사용량 걱정이 줄었다는 증언도 있습니다. 해커뉴스의 한 사용자는 Max 5x 요금제에서 세션 두세 개를 동시에 돌려도 Opus 5.5의 효율 덕분에 일상 작업에는 한도가 충분하다고 썼습니다. 같은 요금제로 더 많은 일을 시킬 수 있게 됐다는 뜻입니다.
- 한 문장 요약: 경쟁 모델로 옮겨 갔던 실사용자들이 다시 돌아올 만큼, 이번 버전업은 체감 폭이 큽니다.
- 리스크: Every 테스터 가운데 두 명은 테스트 기간 중 주간 사용량 한도를 다 썼습니다. 범위가 열린 작업은 한도를 빨리 먹습니다.
Opus 5.5 실제 후기: 같은 일을 Sonnet 5.5와 나눠 맡겨 보니
도입부의 평가를 남긴 개발자 yskkkkkk는 운영 중인 서비스의 오전 트래픽 급증 원인을 찾는 로그 조사를 같은 프롬프트로 Opus 5.5와 Sonnet 5.5에 한 번씩 맡겼습니다. Pro 요금제 기준으로 Opus는 29분 동안 5시간 한도의 17%를 썼고, Sonnet은 22분 동안 14%를 썼습니다. 7일 치 로그에서 이전에 없던 접근 경로를 찾아낸 건 Opus 쪽뿐이었습니다. 일하는 방식도 달랐습니다. Sonnet은 단계마다 중간 보고를 했고, Opus는 끝까지 조사한 뒤 한 번에 정리했습니다.
그는 출시 후 2주 동안 거의 모든 작업을 Opus 5.5로만 했고, 속도와 토큰 소모가 Opus 5보다 눈에 띄게 나아졌다고 평가했습니다. 쓰면 쓸수록 쾌적하다는 체감이 도입부의 "장점만 존재하는 버전업"이라는 표현으로 이어졌습니다. 결과 품질이 확연히 달라졌는지는 아직 모르겠다는 단서도 함께 달았습니다.
해외 뉴스레터 Why Try AI의 Daniel Nest도 같은 결론에 도달했습니다. 그는 톤 맞추기, 나쁜 아이디어에 반대하기, 짧은 소설 쓰기 같은 대화형 과제 9개로 Opus 4.6, Opus 5, Opus 5.5를 비교했고, 점수는 Opus 4.6이 6점, Opus 5.5가 4점, Opus 5가 0점이었습니다. 그런데도 그는 실제 작업용으로는 Opus 5.5로 갈아탔는데, 긴 작업을 함께할 때 빠르고 Opus 5보다 훨씬 덜 거슬린다는 이유였습니다.
Daniel Nest의 Opus 5.5 vs 4.6 비교 바로가기
- 한 문장 요약: 실제로 매일 쓰는 사람들은 빨라진 속도와 줄어든 사용량을 가장 크게 체감했습니다.
- 리스크: 대화 상대로서의 맛은 구버전이 낫다는 평가가 있고, 두 후기 모두 소수의 실행으로 판단한 결과입니다.
Opus 5.5 실제 후기: 어려운 버그는 두 배 더 찾아냈습니다
코드 리뷰 서비스를 운영하는 CodeRabbit은 Opus 5.5를 자사 리뷰 시스템에 붙여 버그 탐지율을 측정했습니다. 오픈소스 버그 패턴 80개에서는 기존 리뷰어 61.3%, Opus 5.5 63.8%로 비슷했습니다. 차이는 어려운 사례 13개에서 났습니다. Opus 5.5는 최대 추론 설정에서 10개를 찾아 76.9%를 기록했고, 기존 리뷰어는 5개, 38.5%에 그쳤습니다. 쉬운 문제에서는 비슷하고 어려운 문제에서 두 배 차이가 난다는 건, 사람이 놓치기 쉬운 버그를 잡는 데 Opus 5.5가 특히 강하다는 뜻입니다.
대가도 있습니다. 같은 측정에서 토큰 사용량은 40~49% 늘었고, 리뷰 코멘트 수도 함께 늘었습니다. CodeRabbit도 더 많이 찾아내는 대신 모델이 하는 일의 양이 늘어나는 것을 대가로 꼽았습니다. Every 테스트에서도 10분 안에 교육 진행표를 만들라는 과제에서 Opus 5.5가 자료를 만드느라 시간을 넘겨 정작 진행표를 내지 못한 장면이 있었습니다.
- 한 문장 요약: 어려운 문제일수록 차이가 커서, 꼼꼼함이 필요한 리뷰와 디버깅에서 강점이 뚜렷합니다.
- 리스크: 더 많이 찾는 만큼 토큰과 시간을 더 쓰고, 끝낼 조건이 없으면 범위를 넘어 일합니다.
Opus 5.5 실제 후기: 아쉬운 점은 장황함, 거절, 그리고 성능 저하 논란
호평이 많은 만큼 불만도 분명히 있는데, 가장 자주 나온 건 장황함입니다. 해커뉴스의 Opus 5.5 프롬프트 가이드 스레드에서 한 사용자는 Claude Code의 출력 스타일을 간결하게 설정했는데도 턴이 끝날 때마다 긴 글을 쓰고, 정작 실행해야 할 내용은 맨 아래에 있다고 지적했습니다. Opus 5보다는 나아졌다는 단서를 달았지만, Every 테스터들도 핵심을 뒤에 묻어 두는 글버릇을 짚었습니다.
거절도 보고됐습니다. 같은 스레드의 다른 사용자는 인터넷에 공개된 자기 웹 앱의 인증 모듈을 보안 점검해 달라고 했다가 거절당했고, 자기가 직접 짠 코드라고 설명해도 통하지 않아 Opus 4.8로 바꾼 뒤에야 점검을 받았다고 썼습니다. 보안 점검처럼 공격 기법을 다루는 작업이 있다면, 거절됐을 때 다른 모델로 넘기는 경로를 미리 준비해 두는 편이 좋습니다.
해커뉴스 Opus 5.5 프롬프트 가이드 스레드 바로가기
출시 5~6일 뒤에는 레딧의 Claude 커뮤니티에 "갑자기 나빠졌다"는 글이 연달아 올라왔습니다. 집계 블로그 admix에 따르면, 평소처럼 1시간 일했을 뿐인데 한도 사용률이 70%에서 90%로 뛰었다는 주장까지 나왔습니다. 하지만 매일 같은 조건으로 성능을 재는 독립 프로젝트 Livenerf의 10월 5일 기준 판정은 "아직 성능 저하가 감지되지 않음"입니다. Livenerf는 30일 측정이 끝나는 10월 24일 이후 최종 결론을 낸다고 밝혔습니다.
Livenerf 성능 추적 프로젝트 바로가기
- 한 문장 요약: 장황함과 거절은 여러 사용자가 반복해서 보고했고, 성능 저하 주장은 아직 측정으로 확인되지 않았습니다.
- 리스크: 성능 저하 측정은 진행 중이라 10월 말 결과에 따라 판단이 바뀔 수 있습니다.
후기를 모아 보면 이렇게 쓰는 게 실속입니다
2주치 후기와 공식 문서를 맞춰 보면, 불만의 상당수는 설정으로 줄일 수 있는 종류였습니다. 실무에서 Opus 5.5를 쓸 때 챙길 점은 세 가지입니다.
첫 번째는 추론 강도를 직접 정하는 것입니다. 기본값이 medium으로 내려갔기 때문에, 이전 버전과 같은 품질을 기대한다면 작업 성격에 맞춰 강도를 명시해야 합니다. 반대로 최대 강도는 비용만 크게 늘린다는 측정이 여럿 나왔으니, medium에서 시작해 부족할 때만 올리는 순서가 안전합니다.
두 번째는 끝낼 조건과 예산을 정해 주는 것입니다. Every의 진행표 사례처럼, Opus 5.5는 범위를 스스로 넓히다가 원래 요청한 결과물을 놓칠 수 있습니다. "10분 안에 진행표 한 장"처럼 결과물의 형태와 한도를 같이 적어 주면 한도 소진과 시간 초과를 함께 줄일 수 있습니다.
세 번째는 거절과 멈춤에 대비하는 것입니다. 자동화 파이프라인에 붙인다면 거절 응답을 받았을 때 다른 모델로 넘기는 경로를 두고, 진행 메시지가 필요한 화면이라면 추론 블록 표시 설정을 바꿔야 합니다. 둘 다 공식 문서에 방법이 나와 있습니다.
결론: 체감되는 버전업, 설정만 챙기면 됩니다
Claude Opus 5.5는 가격은 내리고 속도와 효율은 올린, 2주치 후기가 대부분 "확실히 좋아졌다"고 말하는 버전업입니다. 경쟁 모델로 갔던 개발자들이 돌아오고, 최고 등급 모델 대신 주력으로 삼는 사람이 나올 만큼 체감 폭이 큽니다. 장황함과 거절은 아직 남아 있지만, 추론 강도와 끝낼 조건, 거절 대비 경로만 챙기면 지금 가장 실속 있게 쓸 수 있는 Claude 모델입니다.
리트머스는 새 모델이 나올 때마다 실제 프로젝트 자료로 검증한 뒤, 기획·구현·검수 단계마다 맞는 모델과 설정을 배치합니다. 기획서 한 장이나 참고 서비스 링크만 있어도 우리 프로젝트에 어떤 AI 개발 방식이 맞는지 무료로 검토해 드립니다.
Opus 5.5 한 모델의 변화를 봤다면, 다음으로 궁금한 건 같은 날 나온 OpenAI의 GPT-6 Sol과 나란히 놓았을 때 어느 쪽이 우리 프로젝트에 맞느냐일 겁니다.